ChatGPT에 질문하면 AI가 내 문장을 그대로 검색창에 넣을까요? 그렇지 않아요. AI는 질문을 짧은 검색어로 바꾸고, 결과를 읽어 본 뒤, 부족하면 더 좁힌 검색어로 다시 찾아요. 사람이 자료를 조사하는 순서와 거의 같습니다.
다만 어떤 검색엔진을 쓰는지, 몇 번이나 다시 찾는지는 AI마다 달라요. 이 글은 ChatGPT, Google AI 모드·Gemini, Perplexity, Claude, 네이버 AI탭의 검색 과정을 각 회사의 공식 문서와 발표로 확인되는 것만 골라 정리했어요. 공식 확인이 안 된 내용은 '비공식'이라고 따로 표시했습니다.
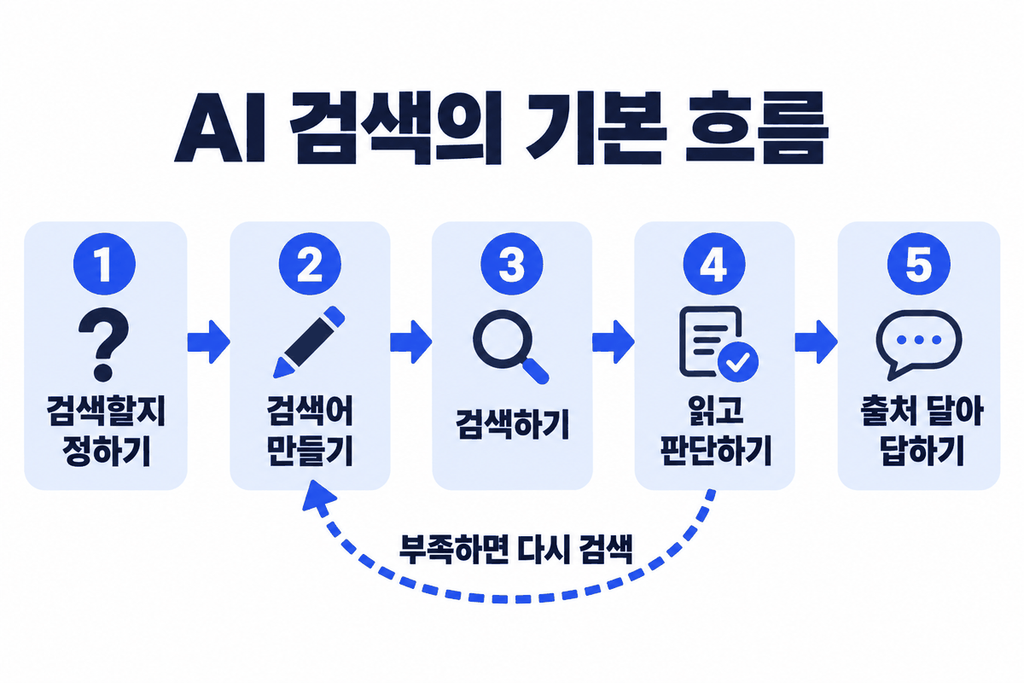
AI 검색의 기본 흐름 5단계
회사마다 부르는 이름은 달라도 뼈대는 같아요.
검색할지 정하기: 최신 정보가 필요한 질문인지 먼저 판단해요. Anthropic 문서를 보면 Claude는 최근 뉴스, 가격, 바뀌었을 수 있는 회사·제품 정보는 검색하고, 수학이나 코딩 개념, 창작처럼 이미 아는 내용은 검색 없이 답해요.
검색어 만들기: 긴 질문을 검색엔진이 알아듣는 짧은 검색어 1개 이상으로 바꿔요.
검색하기: 검색엔진에 보내 결과 목록을 받아요.
읽고 판단하기: 결과가 질문에 맞는지, 빠진 정보가 무엇인지 따져 봐요.
다시 검색하거나 답하기: 부족하면 2단계로 돌아가 더 좁힌 검색어로 찾고, 충분하면 출처를 붙여 답해요.
실제 예시: OpenAI가 공개한 ChatGPT의 검색어
OpenAI 고객센터에는 ChatGPT가 질문을 검색어로 어떻게 바꾸는지 예시가 실려 있어요.
단계 | 내용 |
|---|---|
사용자 질문 | 암 치료용 CCR8 표적 약물 개발, 최근 소식이 뭐야? |
1차 검색어 | CCR8 immunotherapy drug development 2025 |
1차 결과 검토 | 처음 결과를 읽고 더 구체적으로 찾을 대상을 정해요 |
2차 검색어 | CHS-114 conference 2025 |
긴 질문이 핵심 단어와 연도만 남은 검색어로 줄었고, 두 번째 검색어는 특정 약물 이름과 학회로 좁혀졌어요. Anthropic도 자사 리서치 시스템의 검색 원칙을 '넓게 시작해서 좁혀 간다'로 설명합니다.
검색 깊이는 3단계
종류 | 하는 일 | 검색 횟수 |
|---|---|---|
빠른 검색 | 질문을 검색 도구에 보내고 상위 결과로 바로 답해요. 따로 계획을 세우지 않아요. | 적음 |
생각하며 검색 | 생각하는 도중에 검색하고, 결과를 분석해 더 찾을지 스스로 정해요. | 여러 번. Claude 기준 단순한 사실 확인은 1~3회, 비교나 여러 대상 조사는 10회 이상 |
딥 리서치 | 조사 계획을 세우고 몇 분 동안 검색과 읽기를 반복해 보고서를 써요. | 수십~수백 번. Perplexity는 수십 번 검색해 수백 개 출처를 읽고, OpenAI는 수백 개 출처를 참고한다고 밝혀요 |
이 구분은 OpenAI 개발자 문서를 따랐어요. 같은 AI라도 어떤 모델과 모드를 고르느냐에 따라 검색 횟수가 크게 달라집니다.
AI별 검색 과정
1. ChatGPT
쓰는 검색엔진: 자체 크롤러 OAI-SearchBot으로 모은 정보와 외부 검색 파트너. OpenAI 고객센터는 검색 파트너의 개인정보 처리방침으로 Microsoft와 Shopify를 안내해요.
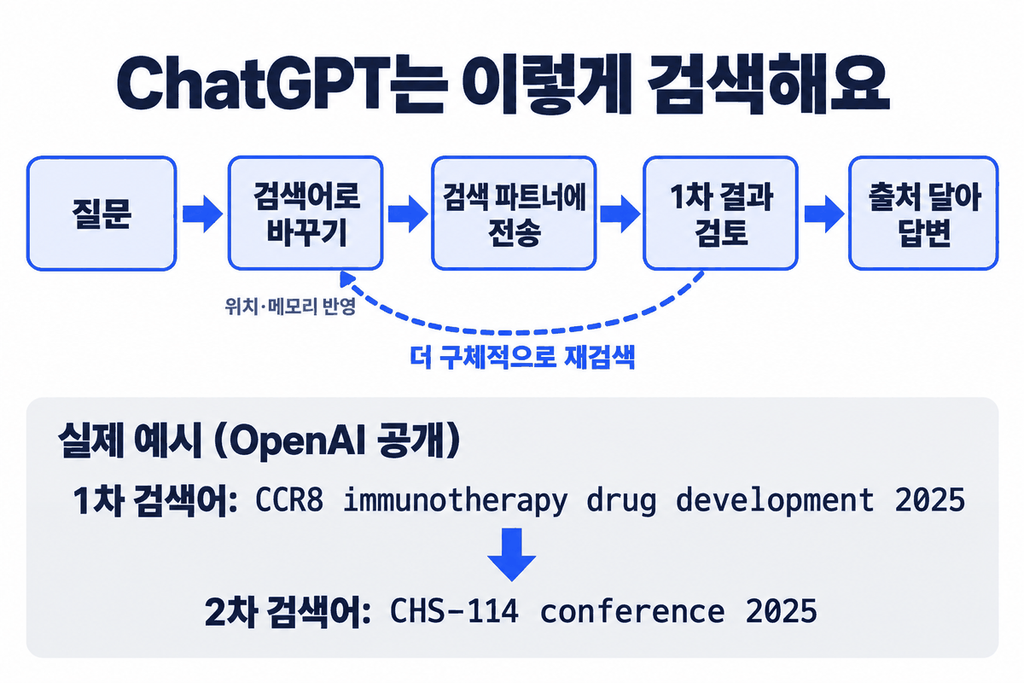
검색 결정: 최신 정보가 도움이 되는 질문이면 자동으로 검색해요. 도구 메뉴에서 검색을 직접 고를 수도 있어요.
검색어로 바꾸기: 질문을 검색어 1개 이상으로 다시 써요. IP로 짐작한 대략적인 위치와 저장된 메모리도 반영해요. 예를 들어 "근처 괜찮은 식당 알려 줘"는 샌프란시스코에 있는 사용자라면 "top restaurants San Francisco"가 되고, 비건이라고 기억해 둔 사용자라면 "good vegan restaurants San Francisco"가 돼요.
검색 파트너에 보내기: 검색어와 대략적인 위치는 보낼 수 있지만, IP 주소나 계정 정보는 보내지 않아요.
1차 결과 보고 다시 검색: 처음 결과를 검토한 뒤 더 구체적인 검색어를 다른 검색 파트너에 보낼 수 있어요.
답변: 인용 링크를 달아 답하고, '출처' 버튼으로 인용한 곳과 관련 링크를 보여 줘요.
확인할 수 있는 것: 개발자용 API 응답의 web_search_call에는 대부분 실제로 쓴 검색어와 행동(검색, 페이지 열기, 페이지 안에서 찾기)이 담겨요. sources에는 참고한 URL 전체가 나오는데, 보통 답변에 인용된 링크보다 많아요.
내 사이트가 나오려면: OAI-SearchBot의 크롤링을 허용하고, 호스팅이나 CDN이 OpenAI 검색봇 IP를 막지 않는지 확인해야 검색 결과에 포함될 수 있어요.
비공식: 외부 분석에서는 ChatGPT 검색에 Google 검색 결과가 섞여 쓰인다는 정황이 나왔어요(2025년 SerpApi 보도, 2026년 9월 Peec 분석). OpenAI가 확인한 내용은 아니에요.
2. Google AI 개요·AI 모드, Gemini
쓰는 검색엔진: Google 검색 색인
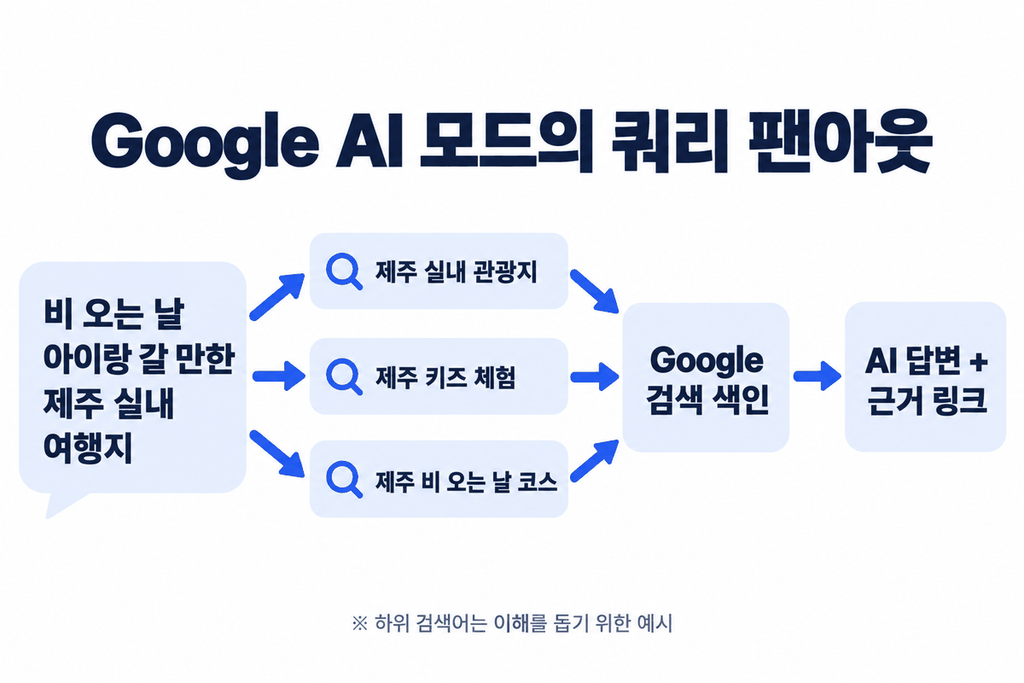
질문 나누기: 질문을 여러 하위 주제로 나눠요.
여러 검색을 한꺼번에: 하위 주제마다 관련 검색을 여러 개 실행해요. Google은 이를 쿼리 팬아웃(query fan-out)이라고 부르고, AI 개요와 AI 모드 모두 이 방식을 쓸 수 있다고 밝혔어요.
근거 페이지 찾기: 답을 만드는 동안 근거가 될 페이지를 더 찾아요. 그래서 일반 검색보다 더 넓고 다양한 링크가 나올 수 있어요.
답변: AI 답변과 함께 근거 링크를 보여 줘요.
예를 들어 "비 오는 날 아이랑 갈 만한 제주 실내 여행지"를 물으면 '제주 실내 관광지', '제주 키즈 체험', '제주 비 오는 날 코스'처럼 나눠 찾는 식이에요. 이 하위 검색어는 이해를 돕기 위해 만든 예시이고, Google이 공개한 실제 검색어는 아니에요.
Gemini 딥 리서치는 한 단계 더 나가요. 질문을 여러 항목으로 된 조사 계획으로 바꾸고, 스스로 웹을 검색하며 페이지를 읽어요. 모은 정보를 되풀이해 따져 보며 다음 행동을 정하고, 그 생각 과정을 보여 준 뒤 보고서로 정리해요.
확인할 수 있는 것: Gemini API의 Google 검색 그라운딩은 검색이 필요한지 판단하고, 검색어를 1개 이상 만들어 실행한 뒤, 결과를 종합해 답해요. 응답에는 인용과 함께 모델이 실행한 검색어 목록이 담겨요.
내 사이트가 나오려면: Google 검색에 색인되고 스니펫이 표시될 수 있는 상태면 돼요. Google은 AI 기능을 위한 별도 파일이나 마크업은 필요 없다고 안내해요.
3. Perplexity
쓰는 검색엔진: 자체 인덱스와 외부 검색 결과의 조합. Perplexity가 공식적으로 밝힌 건 자체 인덱스예요. PerplexityBot이 웹을 수집하고, 2천억 개가 넘는 URL을 추적하는 인덱스가 Perplexity 답변을 뒷받침한다고 설명해요. 외부 검색엔진을 얼마나 섞는지는 공개하지 않았어요.
검색: 질문에 맞는 결과를 자체 인덱스에서 찾아요. 문서 전체뿐 아니라 문서 안의 작은 단락까지 점수를 매기고, 여러 단계로 순위를 다시 매겨 가장 알맞은 조각을 모델에 넘겨요.
필요하면 페이지 직접 방문: 정확한 답을 위해 Perplexity-User가 웹페이지에 직접 들어가기도 해요. 사용자가 요청한 방문이라 robots.txt 규칙을 대체로 따르지 않는다고 Perplexity가 밝히고 있어요.
답변: 출처 링크를 달아 답해요.
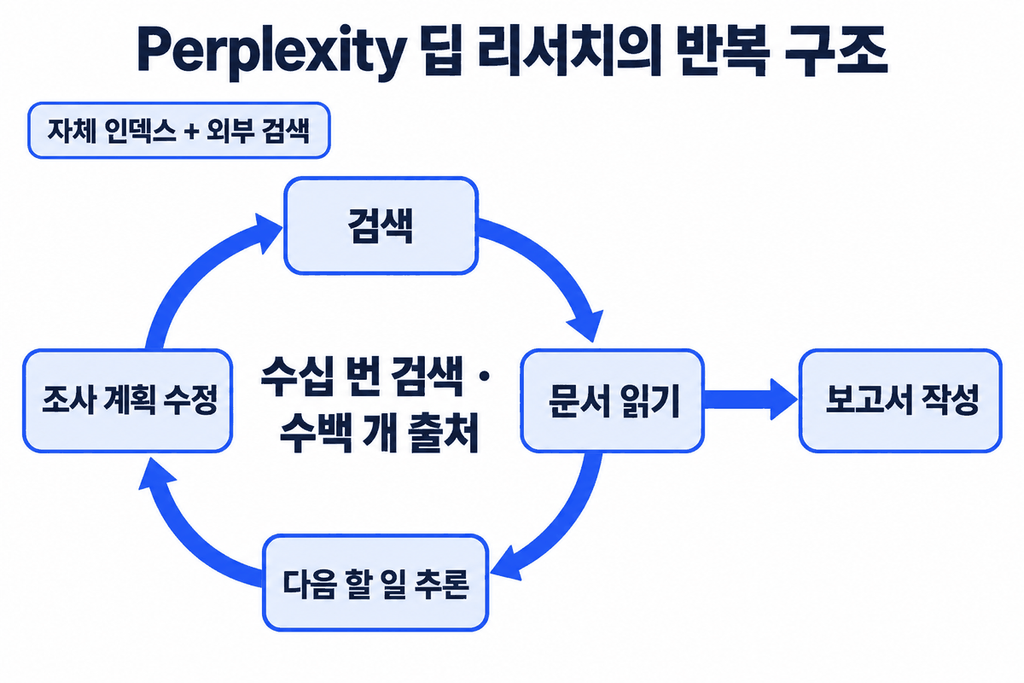
딥 리서치는 공식 설명에 반복 과정이 분명하게 나와요. 검색 → 문서 읽기 → 다음에 할 일 추론 → 알게 된 내용으로 조사 계획 수정을 되풀이하면서 수십 번 검색하고 수백 개 출처를 읽은 뒤 보고서를 써요.
확인할 수 있는 것: 답변마다 출처 목록이 붙어요. 일부 출처에는 Government·Academic·Trusted 라벨이 붙는데, Perplexity가 사이트 단위로 심사해 붙이는 표시예요.
내 사이트가 나오려면: robots.txt와 방화벽에서 PerplexityBot을 막지 않았는지 확인하세요.
비공식: 외부 검색 결과를 함께 쓴다는 정황은 여러 번 나왔어요. 2024년 3월 The Information 보도를 인용한 Tom's Guide 기사에 따르면 Perplexity는 Bing API를 순위 신호로 쓰고, Google 데이터도 제3자를 통해 가져오는 것으로 보였어요. 아라빈드 스리니바스 CEO도 링크 품질을 판단하는 데 Google 순위 신호가 가장 낫다고 보면 쓴다고 인정했어요. 2025년 10월에는 Reddit이 소송을 내면서 Perplexity가 스크래핑 업체(SerpApi 등)에서 Google 검색 결과를 사들였다고 주장했어요. Google 크롤러만 볼 수 있게 만든 게시물이 몇 시간 만에 Perplexity 답변에 나왔다는 내용이에요. 소송 주장일 뿐이고 Perplexity는 다투고 있어요.
4. Claude
쓰는 검색엔진: Brave Search. Anthropic이 공개하는 하위 처리자(subprocessor) 목록에 2025년 3월 '웹 검색' 용도로 올라갔고, Claude의 검색 결과가 Brave 결과와 일치한다는 외부 검증도 있어요. 다만 제품 안내 문서에 직접 적혀 있지는 않아요.
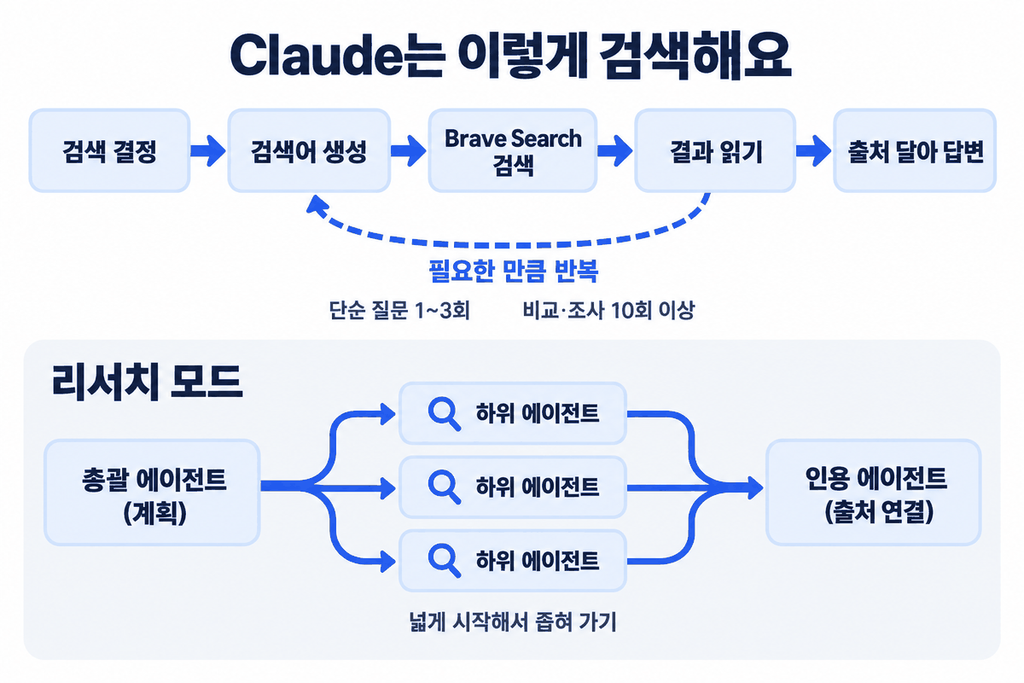
검색 결정: 최근 소식, 가격, 바뀌었을 수 있는 정보가 필요하면 검색하고, 이미 아는 내용이면 바로 답해요.
검색어 만들고 검색: Claude가 검색어를 만들면 시스템이 검색을 실행하고 결과를 Claude에게 돌려줘요.
필요한 만큼 반복: 한 번 답하는 동안 이 과정을 여러 번 되풀이할 수 있어요. 단순한 사실 확인은 보통 1~3회, 비교나 여러 대상 조사는 10회 이상 검색해요.
결과 거르기: API의 최신 검색 도구에서는 Claude가 코드를 직접 짜서 검색 결과를 걸러 낸 뒤 필요한 내용만 읽어요.
답변: 출처를 붙여 답해요.
Claude 리서치 기능은 여러 AI가 나눠서 조사해요. 총괄 에이전트가 조사 계획을 세우고, 하위 에이전트 여러 개가 동시에 검색해요. 처음에는 넓은 검색어로 어떤 자료가 있는지 살피고 점점 좁혀 가요. 결과가 나올 때마다 품질을 평가하고 빠진 부분을 찾아 다음 검색어를 다듬어요. 마지막에는 인용 담당 에이전트가 주장마다 출처를 연결해요.
확인할 수 있는 것: API 응답의 server_tool_use에 실제 검색어가, web_search_tool_result에 결과 페이지의 URL·제목·갱신 시점(page_age)이 담겨요. 인용에는 원문이 최대 150자까지 함께 붙어요.
내 사이트가 나오려면: Brave 크롤러는 따로 이름을 쓰지 않고, Googlebot이 들어갈 수 없는 페이지는 수집하지 않아요. Googlebot을 막으면 Claude 검색에서도 빠질 수 있다는 뜻이에요. Anthropic의 Claude-SearchBot(검색 품질용 수집)과 Claude-User(사용자 요청 시 방문)를 막아도 노출이 줄 수 있다고 Anthropic이 안내해요.
5. 네이버 AI탭
쓰는 검색엔진: 네이버 검색과 플레이스·쇼핑·예약·블로그 같은 네이버 서비스
AI탭은 2026년 4월 28일 네이버플러스 멤버십 베타로 시작해 6월 말 전체 이용자에게 정식 출시됐어요. 네이버가 7월 2일 'AI검색 테크 딥톡'에서 공개한 처리 과정은 다음과 같아요.
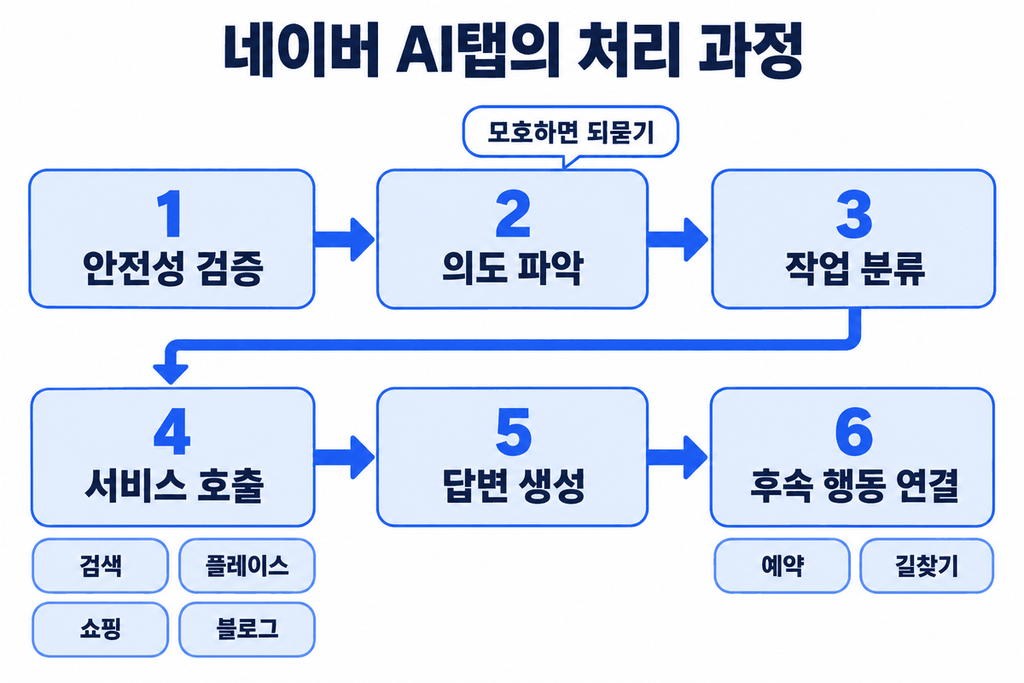
안전성 검증: 질문이 들어오면 먼저 안전한 질문인지 확인해요.
의도 파악: 사용자가 무엇을 원하는지 파악해요. 답을 확신할 수 없는 모호한 질문에는 추측하지 않고 되물어요. "그 드라마 주인공이 누구야?"라고 물으면 "어떤 드라마를 말씀하시는 건가요?"라고 확인하는 식이에요.
작업 분류: 장소 찾기, 상품 비교처럼 어떤 일인지 나눠요.
서비스 호출: 검색, 플레이스, 쇼핑, 블로그 중 필요한 서비스를 불러와요.
답변 생성: 가져온 결과를 분석해 답을 만들어요.
후속 행동 연결: 예약이나 길찾기처럼 다음 행동으로 이어 줘요.
네이버가 든 예시는 "정자동 근처 회식 장소 추천"이에요. AI탭은 플레이스 검색 결과와 리뷰를 분석해 주차가 되는지, 분위기가 어떤지 판단한 뒤 추천해요. 모델은 하이퍼클로바X를 바탕으로 검색·쇼핑·예약에 맞춰 만든 모델이고, 큰 모델 하나 대신 역할별 작은 모델 여러 개가 일을 나눠 맡는 구조라고 설명했어요.
공개되지 않은 것: 질문 하나에 몇 번 검색하는지, 실제로 어떤 검색어를 쓰는지는 공개되지 않았어요.
한눈에 비교
구분 | ChatGPT | Google AI 모드·Gemini | Perplexity | Claude | 네이버 AI탭 |
|---|---|---|---|---|---|
쓰는 검색엔진 | 자체(OAI-SearchBot) + 외부 검색 파트너 | Google 검색 | 자체 인덱스 + 외부 검색(구성 비공개) | Brave Search | 네이버 검색·서비스 |
검색어 만들기 | 질문을 검색어 1개 이상으로 다시 씀(위치·메모리 반영) | 하위 주제별로 여러 검색(쿼리 팬아웃) | 세부 방식 비공개 | Claude가 검색어를 만듦 | 의도 파악 후 작업 분류 |
다시 검색하기 | 1차 결과 검토 후 더 구체적으로 재검색 | 여러 검색 동시 실행, 딥 리서치는 반복 | 딥 리서치: 검색→읽기→추론→계획 수정 반복 | 필요한 만큼 반복(단순 1~3회, 조사 10회 이상) | 서비스 호출 후 리뷰 분석(횟수 비공개) |
검색어 확인 | API | API 응답의 검색어 목록 | 공개 문서 없음(출처 목록만) | API | 비공개 |
내 사이트 노출 조건 | OAI-SearchBot 허용 | Google 색인 + 스니펫 표시 가능 | PerplexityBot 허용 | Brave 색인(Googlebot 허용 필요), Claude-SearchBot 허용 | 네이버 검색 노출, 플레이스·쇼핑 정보 |
마케터가 챙길 점
AI는 질문을 그대로 검색하지 않아요. 제품명, 지역, 연도처럼 짧은 검색어로 찾았을 때 걸리는 페이지가 있어야 해요.
두 번째 검색이 더 구체적이에요. 모델명, 성분명, 행사명 같은 고유명사가 페이지에 정확히 적혀 있어야 좁혀 들어오는 검색에 다시 걸려요.
AI마다 보는 검색엔진이 달라요. Google, Bing, Brave, Perplexity, 네이버 색인을 각각 확인하세요. 특히 Googlebot을 막으면 Google뿐 아니라 Claude 검색에서도 빠질 수 있어요.
AI 크롤러는 대부분 자바스크립트를 실행하지 않아요. Vercel 조사에 따르면 GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot 모두 그래요. 중요한 내용은 HTML 텍스트로 넣으세요.
하지 말아야 할 것도 있어요. 팬아웃 검색어를 하나하나 노려 페이지를 찍어내면 Google의 대량 생성 콘텐츠 스팸 정책에 걸려요.
참고한 자료
Perplexity: Introducing Perplexity Deep Research (2025.2.14)
Perplexity: Architecting and evaluating an AI-first search API (2025.9.25)
Anthropic: How we built our multi-agent research system (2025.6.13)
비공식 참고: Search Engine Land (SerpApi 보도), Peec: ChatGPT search result providers, Tom's Guide: Perplexity의 Bing·Google 신호 사용 (2024.3.21), Bloomberg: Reddit의 Perplexity 소송 (2025.10.22)