📌 TL;DR
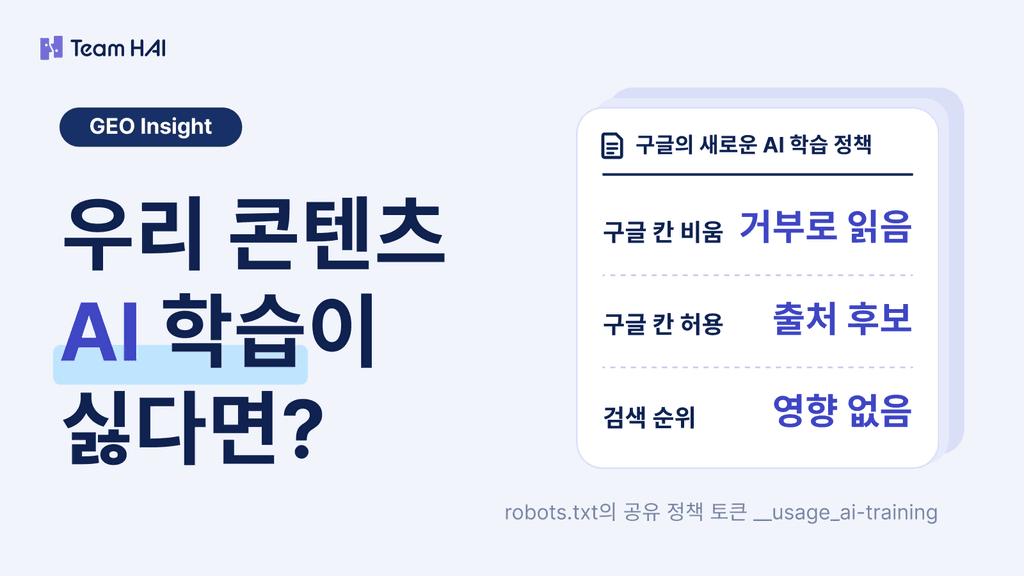
구글은 2026년 10월 30일, robots.txt에 공용 이름표 하나만 적으면 여러 AI 기업에 "우리 콘텐츠로 학습하지 마세요"를 한 번에 알릴 수 있는 공유 AI 학습 제어를 2027년에 지원하겠다고 발표했습니다.
공용 이름표로 학습을 거부하면서 구글 전용 이름표(Google-Extended) 칸을 비워 두면, 구글은 구글 또한 거부한 것으로 읽습니다.
이 경우 Gemini 앱 답변에 출처로 나오는 그라운딩(AI가 답변할 때 웹 페이지를 찾아 읽고 근거로 붙이는 것) 대상에서도 빠질 수 있습니다.구글에서는 학습과 그라운딩이 한 이름표로 묶여 있으므로, Gemini 답변 노출이 필요한 마케터는 구글 전용 이름표에 허용을 따로 적어야 합니다.
우리 콘텐츠로 AI가 학습하는 건 싫어요.
그런데 AI 답변에는 나오고 싶어요."
클라이언트에게 이 말을 듣고 robots.txt를 열었다가, 무엇을 막고 무엇을 열어야 할지 막막했던 적 있으시죠?
구글이 이 고민에 한 가지 기준을 내놓았습니다.
여러 AI 기업에 학습 거부를 한 번에 알리는 방법이에요. 다만 구글에서는 "학습"과 "Gemini 답변의 출처 링크"가 한 묶음으로 움직인다는 점을 꼭 알아 두셔야 합니다.
1. 구글의 간단해진 표준 AI 학습 거부 기준
robots.txt는 웹사이트의 출입 안내문입니다
본론에 앞서 robots.txt부터 짚고 갈게요.
robots.txt는 웹사이트에 붙여 두는 안내문 파일입니다. 검색엔진과 AI 기업의 봇이 사이트에 들어오기 전에 이 파일을 읽고, 어디까지 가져가도 되는지 확인해요.
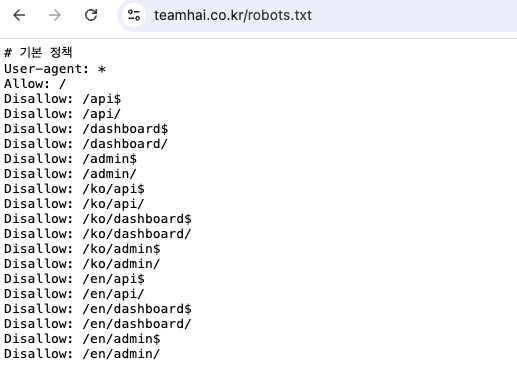
▲ 팀하이 robot.txt 의 예 ▲
안내문에는 봇의 이름을 적고 그 아래에 허용(Allow)과 금지(Disallow)를 씁니다. 지금까지 AI 학습을 막으려면 OpenAI는 GPTBot, Anthropic은 ClaudeBot, 구글은 Google-Extended처럼 AI 기업마다 다른 이름표를 하나씩 찾아 적어야 했습니다.
이제 공용 이름표(정책 토큰) 하나로 여러 AI 기업 학습을 거부할 수 있어요.
구글은 2026년 10월 30일, robots.txt에서 공유 AI 학습 제어를 지원하겠다고 발표했습니다.
기업마다 다른 이름표 대신 여러 AI 기업이 함께 읽는 공용 이름표 하나를 쓰는 방식이에요.
공용 이름표의 실제 표기는 __usage_ai-training입니다.
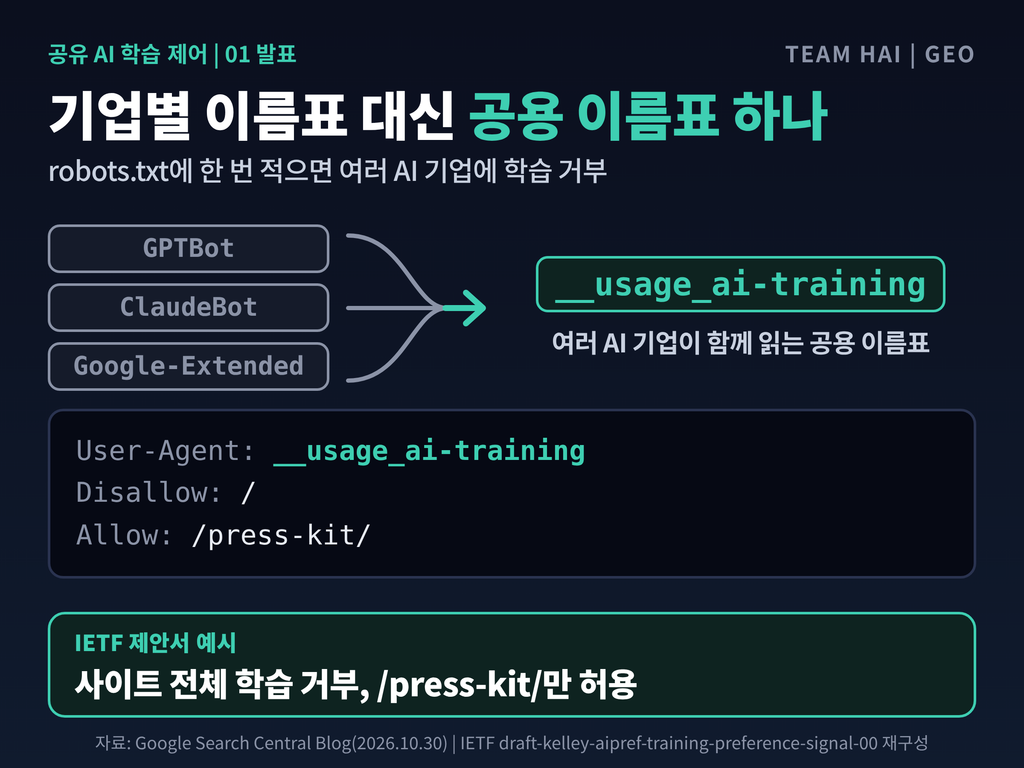
쓰는 법도 지금과 같아요. 봇 이름을 적던 자리에 공용 이름표를 적으면 됩니다.
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
한 줄씩 읽으면 이렇습니다.
첫 줄은 "공용 이름표를 읽는 모든 AI 기업에게",
둘째 줄은 "사이트 전체를 학습에 쓰지 마세요",
셋째 줄은 "단, /press-kit/ 폴더는 학습해도 됩니다"라는 뜻이에요.
인터넷 표준을 정하는 국제 단체 IETF에 제출된 제안서에 실린 예시입니다.
사이트 전체의 학습을 막고 싶다면 앞의 두 줄만 쓰면 됩니다.
구글 칸을 비워 두면, 구글 역시 거부한 것으로 판단합니다.
구글도 AI 봇의 접근을 거부할 수 있습니다.
공용 이름표로 학습을 거부하는 방법으로 구글 전용 이름표(Google-Extended)를 따로 적지 않았다면, 구글은 구글에도 거부한 것으로 판단합니다.
Google-Extended는 구글이 2023년부터 제공해 온 AI 학습 제어용 이름표예요.
구글은 이 이름표에 허용을 분명히 적은 사이트가 Gemini 앱 답변에 그라운딩(AI가 답변할 때 웹 페이지를 찾아 읽고 근거로 붙이는 것)으로 표시되고, 클릭을 받을 수 있는 대상이 된다고 설명했습니다.
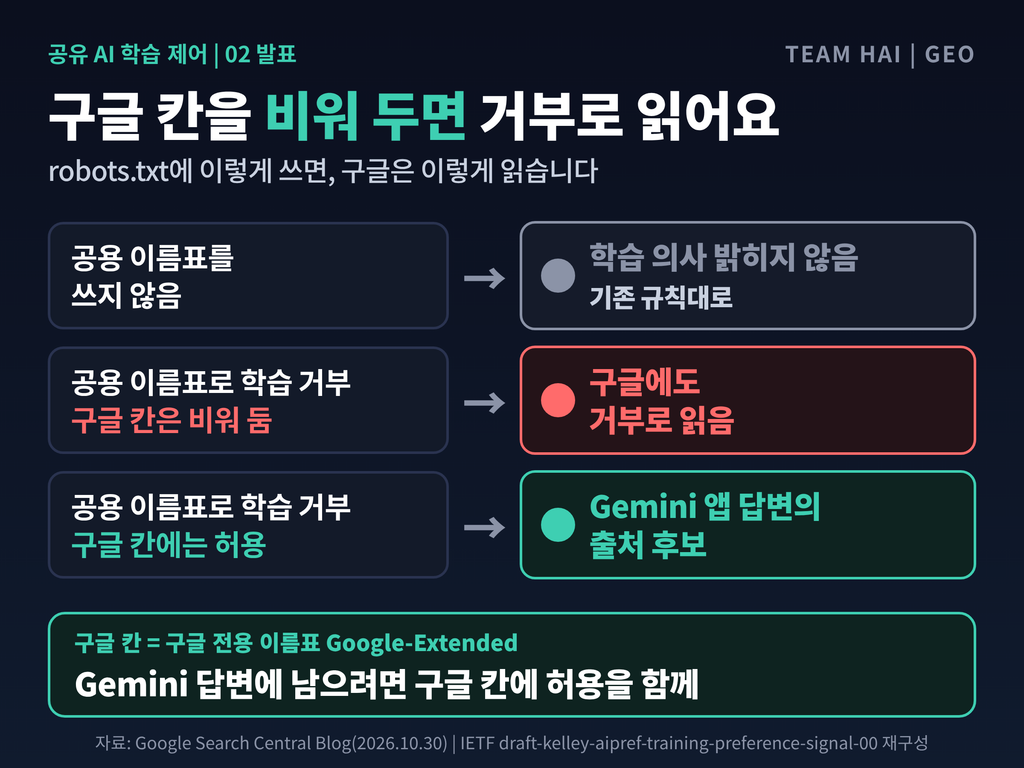
robots.txt에 이렇게 쓰면 | 구글은 이렇게 읽습니다 |
|---|---|
공용 이름표를 쓰지 않음 | 학습 의사를 밝히지 않은 상태. 구글 전용 이름표가 있으면 그 내용대로 |
공용 이름표로 학습 거부, 구글 칸은 비워 둠 | 구글도 거부한 것으로 읽음 |
공용 이름표로 학습 거부, 구글 칸에는 허용 | 구글 전용 이름표대로 허용. Gemini 앱 답변의 출처 후보가 됨 |
기업 전용 이름표는 그대로 쓸 수 있고, 2027년에 시작합니다
공용 이름표가 생겨도 Google-Extended 같은 기업 전용 이름표는 계속 쓸 수 있습니다. 큰 방향은 공용 이름표로 정하고, 특정 기업에만 다르게 말하고 싶으면 그 기업 이름표를 따로 적으면 돼요. 제안서도 더 구체적으로 적은 규칙을 우선하도록 권하고 있습니다.
구글은 2027년에 다른 AI 기업과 함께 이 방식을 지원하는 것이 목표이고, 진행 상황은 따로 알리겠다고 밝혔습니다.
왜 이런 방식이 나왔을까요?
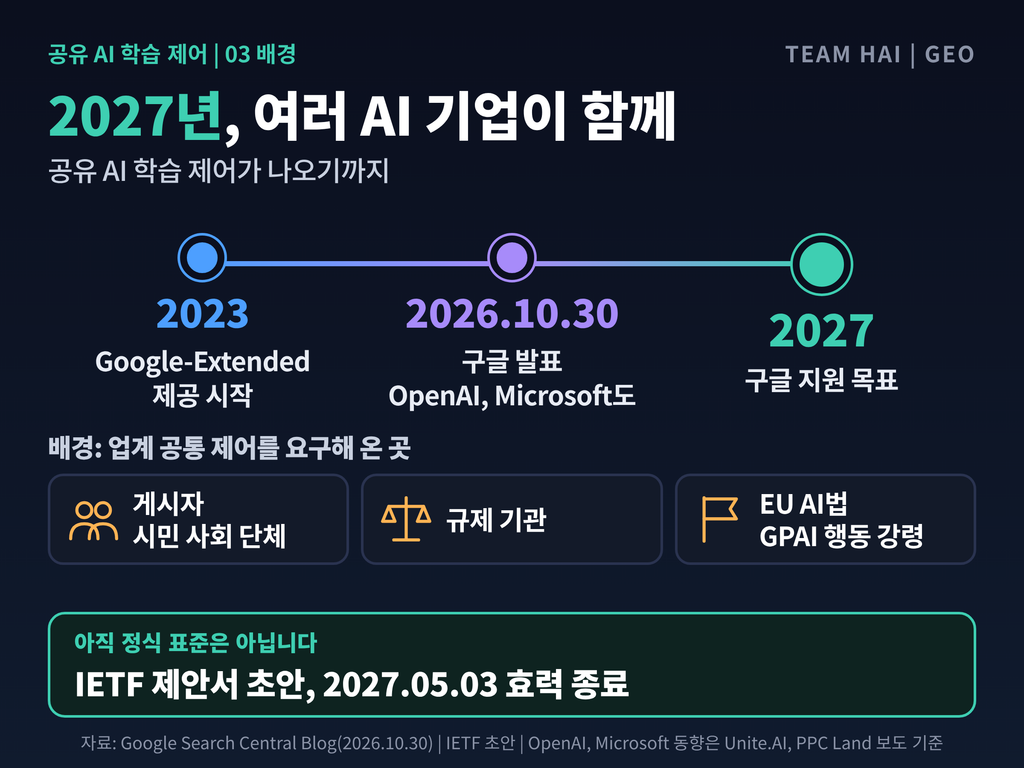
AI 기업이 늘수록 안내문 관리가 어려웠습니다
AI 기업은 계속 늘어나는데, robot.txt에 기입하는 기업의 이름은 각각 다릅니다.
새 기업이 나올 때마다 robots.txt를 고쳐야 하니 빠뜨리는 이름도 생겨요.
공용 이름표는 기업마다 따로 적던 내용을 한 줄로 모으자는 시도입니다.
게시자와 규제 기관이 요구했어요
구글은 이 방식이 업계 전체에 통하는 AI 학습 제어를 요구해 온 게시자, 시민 사회 단체, 규제 기관 등의 의견을 반영했다고 설명합니다. 주요 AI 기업이 함께 지원하면 업계에 오래 쓸 수 있는 표준이 생길 거라는 기대도 덧붙였어요.
유럽도 같은 방향입니다. EU AI법에 따른 범용 AI(GPAI) 모델 제공업체 행동 강령은 robots.txt를 웹사이트가 "기계가 읽을 수 있는 방식"으로 의사를 밝히는 기본 수단으로 인정하고 있어요.
여기서 말하는 'AI 학습'은 무엇일까요?
이 방식은 IETF의 AI 선호(AIPREF) 작업 그룹 논의에서 나왔습니다.
이 그룹이 정한 AI 학습은 글이나 이미지를 만들어 내는 생성형 AI 모델이 콘텐츠를 읽고, 그 내용으로 모델의 학습된 값(파라미터)을 바꾸는 일이에요. 생성형이 아닌 작업에만 쓰는 모델의 학습은 여기에 들어가지 않습니다.
하나 더 구분할 점이 있습니다. 공용 이름표는 봇이 사이트에 들어오는 것을 막는 규칙이 아니라, 가져간 콘텐츠를 학습에 써도 되는지를 밝히는 규칙이에요. 가게 출입을 막는 표지판이 아니라, 가져간 물건을 어디에 써도 되는지 적어 둔 메모에 가깝습니다.
같은 날 OpenAI와 Microsoft도 나섰습니다
보도에 따르면 OpenAI는 같은 날 이 공용 이름표를 따르겠다고 밝히고, 몇 달 안에 적용할 계획을 내놓았어요.
Microsoft는 사이트 단위를 넘어 페이지 단위로도 의사를 밝힐 수 있게 하고, AI 답변의 근거로 쓰는 것(그라운딩)에 대한 선택을 따로 두기로 했습니다. 제안서를 쓴 Anthropic의 Kevin Kelley는 Anthropic이 이미 적용을 시작했다고 알렸어요.
2. 마케터가 주의해야 할 점
학습과 그라운딩은 다릅니다
이번 발표를 이해하려면 두 단어를 먼저 나눠야 합니다.
학습(학습봇)은 AI 모델을 만들 때 콘텐츠를 미리 읽혀 모델 안에 녹이는 일이에요. 그라운딩(검색봇)은 사용자가 질문한 순간 AI가 웹 페이지를 찾아 읽고, 그 내용을 근거로 답하면서 출처 링크를 붙이는 일입니다.
시험에 빗대면 쉽습니다.
학습은 시험 전에 교과서를 외워 두는 것이고, 그라운딩은 시험 중에 책을 펴 보고 어디서 봤는지 적는 오픈북이에요.
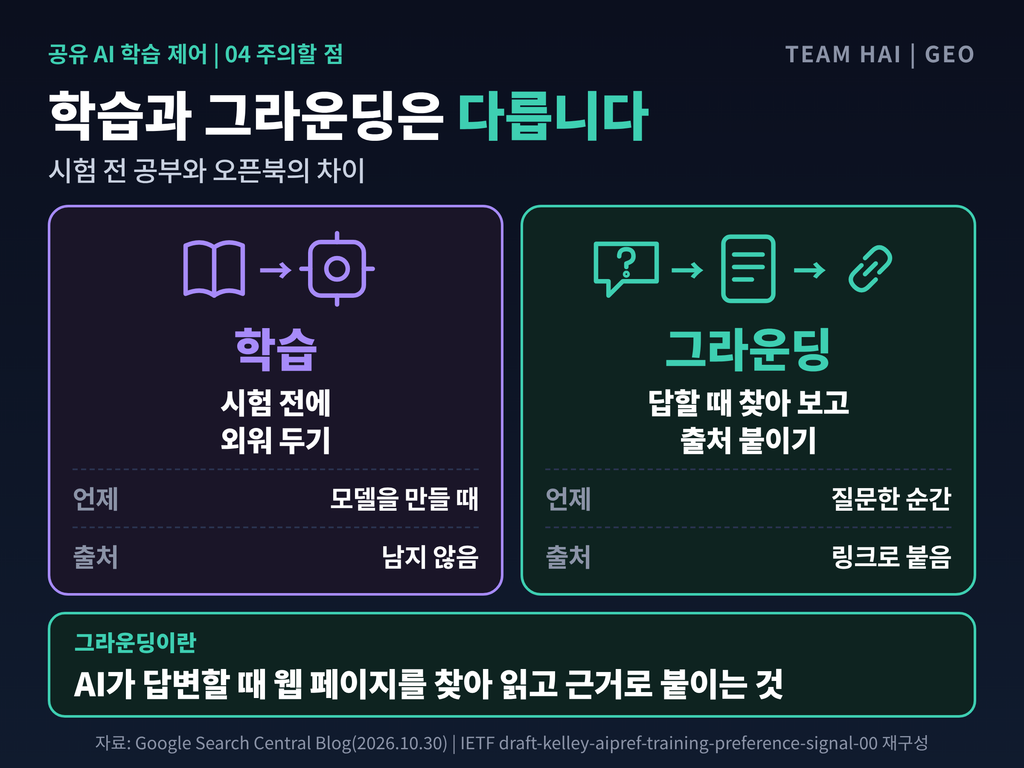
구분 | 학습 | 그라운딩 |
|---|---|---|
언제 쓰이나 | 모델을 만들 때 미리 | 사용자가 질문한 순간 |
콘텐츠가 쓰이는 방식 | 모델 안에 녹아 출처가 남지 않음 | 답변의 근거가 되고 출처 링크가 붙음 |
마케터에게 의미 | 시간이 지나며 AI가 브랜드를 알게 됨 | 지금 답변에 우리 사이트가 출처로 나오고 클릭이 생김 |
학습만 막으려다 Gemini 답변의 출처 링크에서 빠질 수 있어요
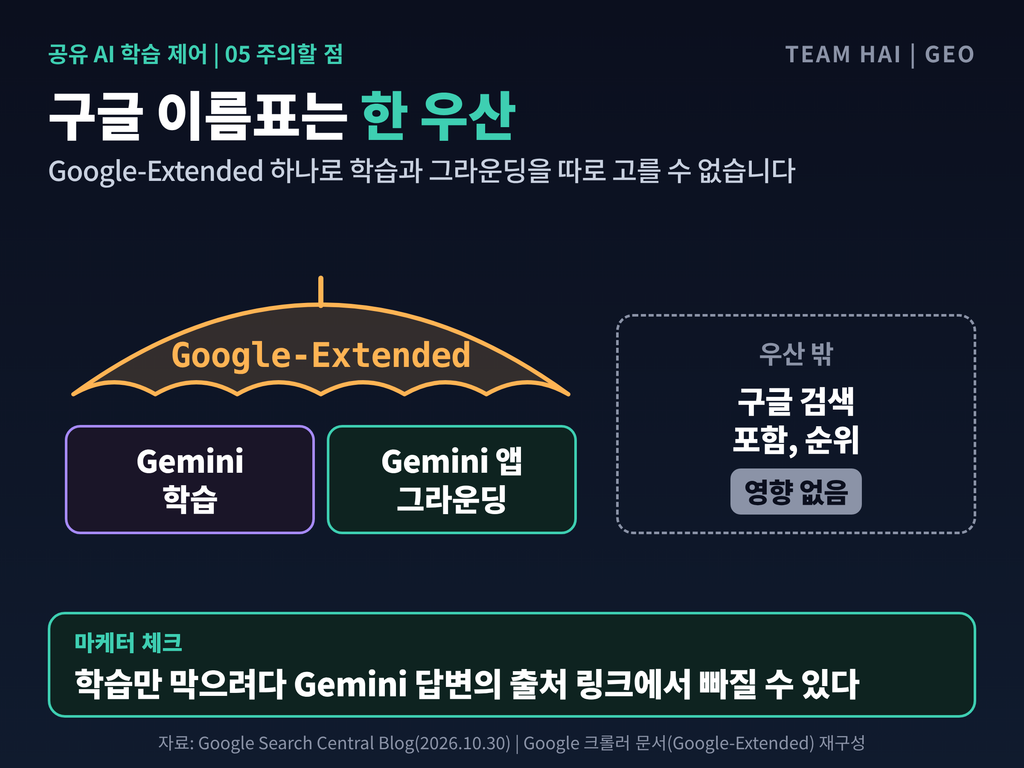
구글 문서에 따르면 Google-Extended 이름표 하나가 차세대 Gemini 모델의 학습과 Gemini 앱의 그라운딩을 함께 다룹니다. 기업용 서비스인 Vertex AI에서 Google 검색 결과를 근거로 붙이는 기능도 여기에 들어가요. 구글에서는 이 이름표 하나로 학습과 그라운딩을 따로 고를 수 없습니다.
그래서 공용 이름표로 학습만 거부하고 구글 칸을 비워 두면, 구글은 구글에도 거부한 것으로 읽고 그라운딩까지 함께 막힐 수 있어요. 학습을 막으려던 선택이 Gemini 앱 답변의 출처 후보에서 빠지는 결과로 이어질 수 있다는 뜻입니다.
robots.txt를 고치기 전에 "막고 싶은 것"과 "열어 두고 싶은 것"부터 적어 보세요. 그 순서만 지켜도 원하지 않은 차단을 피할 수 있습니다.
"모든 봇 금지" 규칙으로는 학습을 거부할 수 없습니다
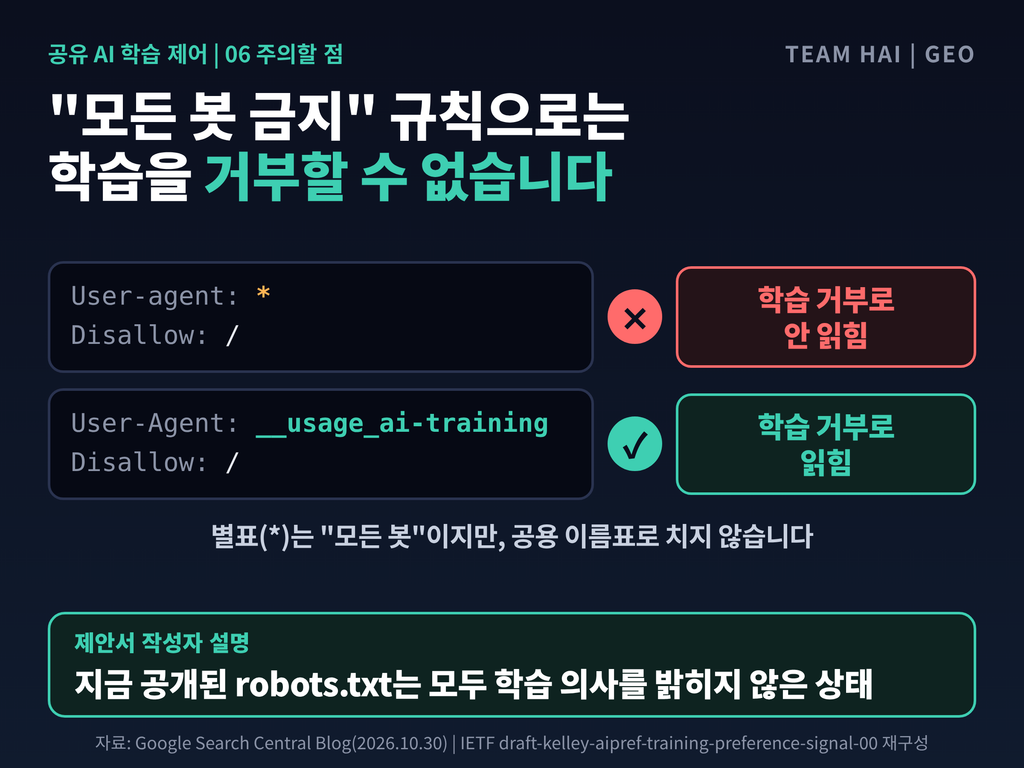
많은 사이트가 robots.txt에 User-agent: 를 씁니다. 별표()는 "모든 봇"이라는 뜻이라, 이 규칙 하나면 AI 학습도 막힌다고 생각하기 쉬워요.
그런데 제안서는 모든 봇에 한꺼번에 거는 규칙을 공용 이름표로 치지 않는다고 정했습니다.
공용 이름표 __usage_ai-training을 따로 적지 않으면, 학습 의사를 아예 밝히지 않은 것으로 봐요. 제안서를 쓴 Kevin Kelley는 지금 공개된 robots.txt가 모두 이 상태라고 설명했습니다.
검색 순위와는 상관없어요
구글은 Google-Extended가 구글 검색에 나오는지 여부나 검색 순위에는 영향을 주지 않는다고 밝혀 왔습니다. 구글 검색 결과와 Gemini 앱 답변은 따로 따져 봐야 해요.
지금 적어도 바로 적용되지는 않습니다
근거가 되는 제안서는 아직 IETF가 승인한 정식 표준이 아니고, 2027년 5월 3일에 효력이 끝나는 초안입니다.
구글의 지원도 2027년이 목표예요. 지금은 우리 사이트가 무엇을 막고 무엇을 열어 둘지 미리 정해 두는 단계입니다.

3. 팀하이 인사이트
이너스커뮤니티의 GEO 서비스 팀하이는 robots.txt를 볼 때 학습과 그라운딩부터 나눕니다.
둘이 영향을 주는 성과가 다르기 때문이에요.
(1) 학습은 장기 인지, 그라운딩은 지금의 인용
학습은 AI가 우리 브랜드를 알게 되는 바탕입니다.
당장 답변에 출처가 붙지는 않지만, AI가 브랜드와 분야를 함께 기억하는 재료가 돼요.
그라운딩은 답변에 우리 사이트가 출처로 붙는 순간입니다.
팀하이가 추적하는 인용률(우리 사이트가 출처로 붙은 응답 ÷ 전체 응답)이 재는 것도 이 결과예요. 학습 거부는 장기 인지에, 그라운딩 차단은 지금의 인용률에 영향을 줍니다.
(2) AI 봇은 세 종류로 나눠 보세요
AI 기업의 봇은 하는 일에 따라 세 종류로 나뉩니다.
모델 학습용으로 콘텐츠를 모으는 학습 봇, AI 답변에 쓸 검색 목록(색인)을 만드는 색인 봇, 사용자가 질문할 때 바로 페이지를 가져가는 실시간 봇이에요.
공용 이름표는 이 중 "학습에 써도 되는지"만 다룹니다.
AI 답변에 출처로 붙는 길을 여는 색인 봇(OAI-SearchBot, Claude-SearchBot, PerplexityBot)은 공용 이름표와 따로 확인해야 해요.
Cloudflare가 2026년 7월, 학습용과 검색용을 나누지 않은 봇은 9월 15일부터 광고가 있는 페이지에서 기본으로 막겠다고 발표한 것도 같은 흐름입니다.
(3) 우리 사이트의 AI 유입 허용 현황은 어떨까요?
정답은 사이트마다 다릅니다. 발표 내용을 기준으로 고를 수 있는 경우를 네 가지로 정리했어요.
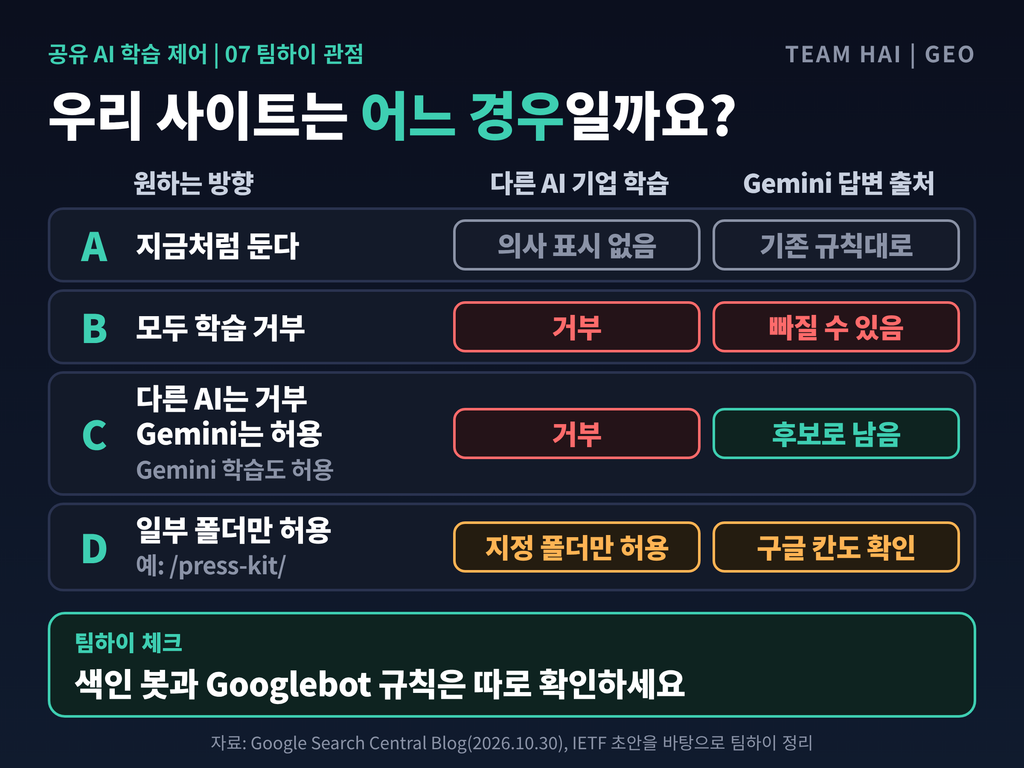
원하는 방향 | robots.txt에 적는 내용 | 구글은 이렇게 읽습니다 (발표 기준) |
|---|---|---|
A. 지금처럼 둔다 | 공용 이름표를 쓰지 않음 | 학습 의사를 밝히지 않은 상태. 구글 전용 이름표가 있으면 그 내용대로 |
B. 모든 AI 기업에 학습 거부 | 공용 이름표 아래 | 구글에도 거부한 것으로 읽음. Gemini 앱 답변의 출처 링크에서도 빠질 수 있음 |
C. 다른 AI 기업은 거부, 구글 Gemini는 허용 | B 내용 + 구글 전용 이름표 아래 | Gemini 앱 답변의 출처 후보로 남음. 대신 구글이 Gemini 학습에 쓰는 것도 허용 |
D. 일부 폴더만 학습 허용 |
| 지정한 폴더만 학습 허용. 보도자료, 브랜드 소개처럼 AI가 정확히 알아야 할 자료를 여는 용도. Gemini 답변이 필요하면 구글 칸도 함께 확인 |
다른 AI 기업의 학습은 거부하고 Gemini 앱 답변에는 출처로 남고 싶다면 C처럼 씁니다.
첫 두 줄은 "모든 AI 기업에 학습 거부", 아래 두 줄은 "구글은 허용"이라는 뜻이에요.
User-Agent: __usage_ai-training
Disallow: /

User-Agent: Google-Extended
Allow: /
이 표는 학습에 관한 내용입니다.
색인 봇과 구글 검색 봇(Googlebot)에 대한 규칙은 따로 확인하세요.
팀하이 GEO 진단에서 보는 항목
팀하이 GEO 진단은 AI 봇이 사이트에 들어올 수 있는지를 기본 항목으로 봅니다.
그중에서도 색인 봇을 robots.txt로 막고 있지 않은지 먼저 확인해요. 학습을 막으려다 색인 봇까지 함께 막으면 AI 답변에 출처로 붙을 기회까지 닫히기 때문입니다.
구글 지원이 시작되면 확인할 것이 하나 늘어요.
공용 이름표와 구글 전용 이름표의 내용이 서로 맞는지, 원하지 않게 그라운딩까지 막고 있지 않은지 함께 점검하세요.
학습을 막을지는 브랜드가 정할 문제입니다. 다만 그 선택이 지금의 AI 답변 노출까지 닫지 않는지 확인하는 일은 마케터의 몫이에요.
다음 편에서는 구글이 실제로 지원을 시작한 뒤 robots.txt가 어떻게 읽히는지 확인해 보겠습니다.

자주 묻는 질문
Q1. 그라운딩이 뭔가요? AI 학습과 어떻게 다른가요?
A1. 그라운딩은 AI가 답변할 때 웹 페이지를 찾아 읽고 그 내용을 근거로 붙이는 것입니다.
답변 아래 붙는 출처 링크가 그 결과예요.
학습은 모델을 만들 때 콘텐츠를 미리 읽혀 모델 안에 녹이는 일이라 출처가 남지 않습니다. 시
험 전에 외워 두는 것이 학습이라면, 시험 중에 책을 펴 보고 어디서 봤는지 적는 오픈북이 그라운딩이에요.
Q2. robots.txt로 모든 AI 기업의 학습을 한 번에 거부할 수 있나요? 구
A2. 글이 지원을 예고한 공용 이름표 __usage_ai-training을 쓰면 됩니다.
봇 이름을 적던 자리에 이 이름표를 적고 아래에 Disallow: /를 쓰면, 이 이름표를 따르는 AI 기업 모두에 학습 거부를 알릴 수 있어요.
다만 근거가 되는 제안서는 아직 정식 표준이 아니고, 구글 지원도 2027년이 목표입니다.
Q3. User-agent: *로 모든 봇을 막아 두면 AI 학습도 거부한 건가요?
A3. 아닙니다. 제안서는 모든 봇에 한꺼번에 거는 규칙을 공용 이름표로 치지 않는다고 정했어요. 공용 이름표를 따로 적지 않으면 학습 의사를 밝히지 않은 것으로 봅니다. 학습을 거부하려면 공용 이름표를 따로 적어야 해요.
Q4. AI 학습은 거부하고 Gemini 답변에는 나오려면 어떻게 써야 하나요? 공용 이름표 아래 Disallow: /를 쓰고, 구글 전용 이름표(Google-Extended) 아래 Allow: /를 함께 적으세요. 구글은 Google-Extended에 허용을 분명히 적은 사이트를 Gemini 앱 답변의 출처 후보로 봅니다. 다만 Google-Extended는 Gemini 학습과 그라운딩을 함께 다루기 때문에, 이렇게 쓰면 구글이 Gemini 학습에 쓰는 것도 허용하게 됩니다.
Q5. 지금 robots.txt에 공용 이름표를 적으면 바로 적용되나요? 아직은 아닙니다. 구글은 2027년에 다른 AI 기업과 함께 지원하는 것을 목표로 하고 있고, 근거가 되는 제안서는 2027년 5월 3일에 효력이 끝나는 초안이에요. 지금은 우리 사이트가 무엇을 막고 무엇을 열어 둘지 미리 정해 두는 단계입니다.
✅ 용어 사전
원래 표현 | 이번 글에서 쓰는 말 |
|---|---|
정책 토큰 | 공용 이름표 (첫 등장에 실제 표기 |
Google-Extended | 구글 전용 이름표 Google-Extended |
회사별 제어 | 기업 전용 이름표 |
토큰 그룹 없음 | 공용 이름표를 쓰지 않음 |
토큰으로 학습 거부 | 공용 이름표로 학습을 거부함 |
Google-Extended 미지정 | 구글 칸을 비워 둠 (구글 전용 이름표를 따로 적지 않음) |
학습 선호 표현 없음 | 학습 의사를 밝히지 않은 상태 |
와일드카드 그룹 | 모든 봇에 한꺼번에 거는 규칙 |
개인 초안 | 아직 정식 표준이 아닌 제안서 |
그라운딩 | 그라운딩(AI가 답변할 때 웹 페이지를 찾아 읽고 근거로 붙이는 것) |
출처 인용
"Supporting a shared AI training control for websites"
- John Mueller, Google Search Central Blog
원문 URL: https://developers.google.com/search/blog/2026/10/ai-training-control
"Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00)"
- Kevin Kelley, IETF Internet-Draft
원문 URL: https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/
"Google's common crawlers: Google-Extended"
- Google Search Central
원문 URL: https://developers.google.com/crawling/docs/crawlers-fetchers/google-common-crawlers#google-extended
"Google, Microsoft, OpenAI and Anthropic back one AI training opt-out"
- PPC Land
원문 URL: https://ppc.land/google-microsoft-openai-and-anthropic-back-one-ai-training-opt-out/
원문 정보
항목 | 내용 |
|---|---|
제목 | Supporting a shared AI training control for websites (한국어판: 웹사이트를 위한 공유 AI 학습 제어 지원) |
매체 / 저자 | Google Search Central Blog / John Mueller(Google 검색 애드보킷) |
발행일 | 2026.10.30 |
원문 URL | https://developers.google.com/search/blog/2026/10/ai-training-control |
1차 자료 | IETF Internet-Draft |
확보 방식 | 구글 글은 짧은 발표문이라 정책 토큰 이름과 문법이 없음. 토큰과 해석 규칙은 IETF 초안 원문 검색 결과로 확인하고, 같은 날 나온 OpenAI, Microsoft 발표는 Unite.AI, PPC Land 보도로 확인 |
관련 글
팀하이 뉴스레터
URL 한 번 입력으로 우리 브랜드 GEO 현황 확인하기
팀하이 '원스톱 시작하기'를 통해 브랜드 등록부터 페이지 진단, CDJ · CEP 기반 AI SOV 분석까지 한 번에 진행할 수 있습니다. 홈페이지의 SEO · AEO · GEO 최적화 상태와 경쟁사 대비 AI 검색 언급 및 인용 현황을 확인하고, 진단 결과를 바탕으로 우리 브랜드에 부족한 정보와 개선이 필요한 부분을 파악할 수 있습니다. 이를 통해 앞으로 보완할 콘텐츠를 찾고 GEO 마케팅 방향을 설정하는 데 도움을 받을 수 있습니다.
김현서
팀하이 사용 설명서
4. 원스톱시작 | GEO 솔루션 팀하이 사용 가이드
팀하이 원스톱시작으로 브랜드 등록부터 페이지 진단, AI SOV 분석, CDJ·CEP 전략 설계까지 한 번에 진행할 수 있어요. 브랜드명, 카테고리, 홈페이지 주소를 입력하면 브랜드와 경쟁사 정보를 불러오고 각 항목의 분석이 자동으로 진행됩니다. 분석이 완료되면 각 진단 결과를 확인하고 우리 브랜드의 GEO 현황과 개선 방향을 살펴볼 수 있어요.
김현서