비싼 모델을 쓴다고 결과가 늘 좋아지지는 않습니다. 일마다 어떤 모델에 맡기고 얼마나 깊게 생각하게 할지 업무별로 골라 봤습니다.
가격과 모델 이름은 2026년 11월 4일 각 사 공식 페이지 기준이고, 성능 비교에는 독립 평가 기관 Artificial Analysis의 수치를 썼습니다.
AI에게 일을 맡길 때 정할 두 가지
회사에는 손 빠른 신입도 있고, 웬만한 일은 혼자 끝내는 에이스 대리도 있고, 어려운 결정을 맡는 전문가도 있습니다. 복사 한 장을 전문가에게 부탁하지 않듯이, AI도 일의 난이도에 맞춰 골라 쓰면 됩니다.
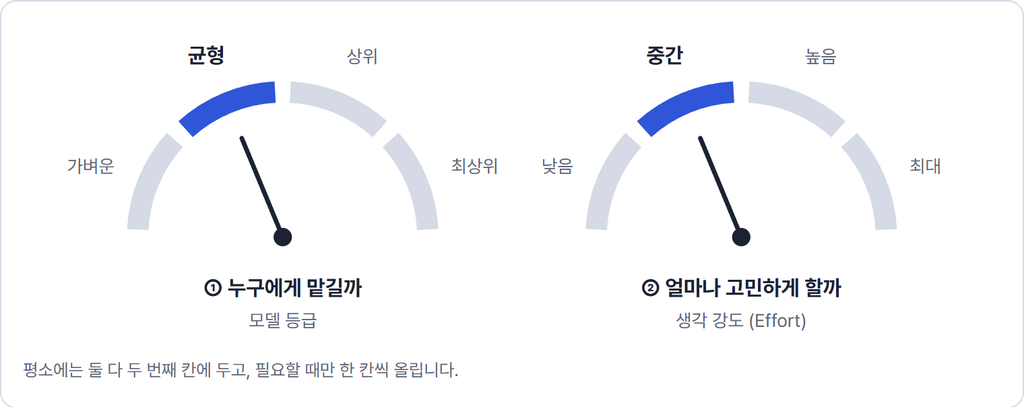
정할 것은 두 가지입니다. 하나는 모델로, 누구에게 맡길지를 정합니다. 다른 하나는 생각 강도(Effort)로, 얼마나 오래 고민하게 할지를 정합니다. 같은 사람에게도 "가볍게 훑어봐"와 "꼼꼼히 다 따져봐"는 결과도, 걸리는 시간도 다릅니다.
회사별 모델 등급
이름은 회사마다 다르지만 등급은 비슷하게 나뉩니다.
등급 | Claude | GPT (OpenAI) | Gemini (Google) |
|---|---|---|---|
최상위 (외부 전문가) | Fable 5.1 | GPT-6 Astra | Gemini 4 Argon |
상위 (팀장) | Opus 5.5 | GPT-6.1 Sol | Gemini Pro |
균형 (에이스 대리) | Sonnet 5.5 | GPT-6.1 Terra | Gemini 3.8 Flash |
가벼운 (손 빠른 신입) | Haiku 5.5 | GPT-6 Luna | Gemini 3.5 Flash-Lite |
모델 이름은 개발자용(API) 표기라 앱 화면에서는 조금 다르게 보일 수 있습니다. 순위는 금방 바뀝니다. 2026년 9~10월 두 달 사이에만 GPT-6 Astra, GPT-6.1 Sol·Terra, Gemini 4 Argon이 새로 나왔습니다. Gemini 4 Argon은 앱에서 Google AI Pro·Ultra 구독자만 쓸 수 있습니다.
최상위 모델은 비용이 얼마나 더 들까
AI 요금은 택시 요금처럼 단가에 거리를 곱해서 나옵니다.
AI는 글을 토큰이라는 작은 조각 단위로 읽고 씁니다. 요금도, 월 구독 요금제의 사용 한도도 이 토큰으로 계산됩니다. 택시에 비유하면 단가는 모델 등급이 정하고, 달리는 거리는 생각 강도가 정합니다.
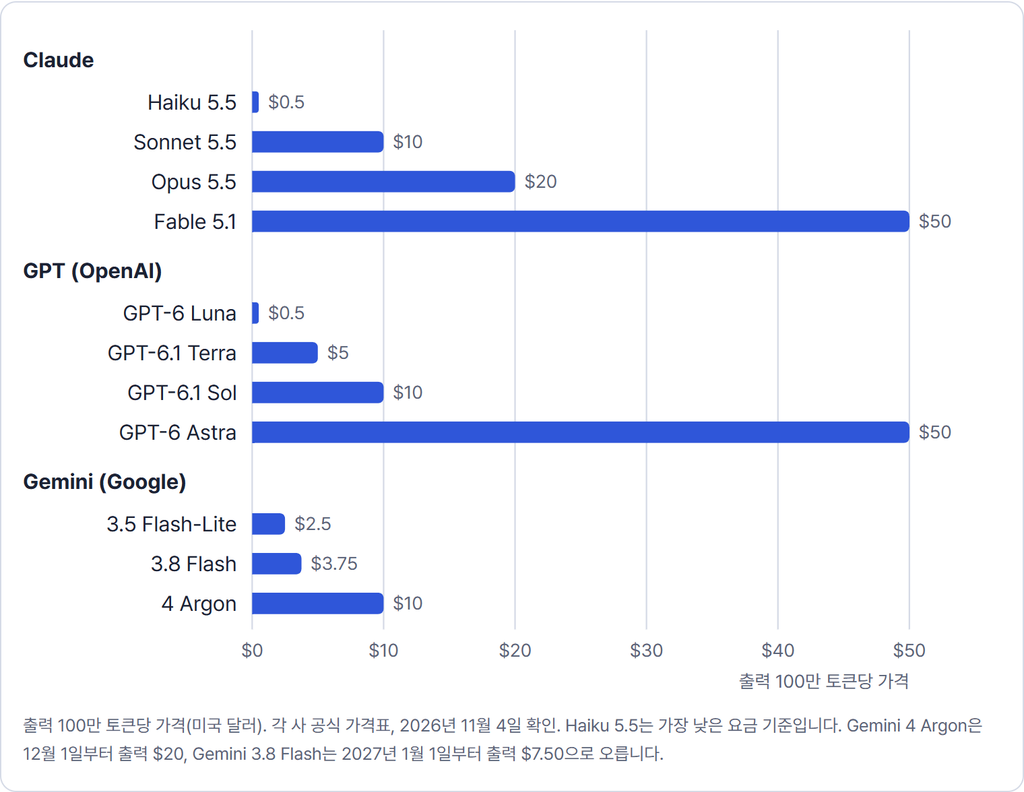
100배. Claude와 OpenAI 모두 최상위 모델의 토큰당 가격이 가장 가벼운 모델의 100배입니다(Claude Fable 5.1 대 Haiku 5.5, GPT-6 Astra 대 GPT-6 Luna, 입력·출력 모두). 같은 분량이라면 Fable 5.1이나 GPT-6 Astra에 한 번 맡길 값으로 가벼운 모델을 100번 쓸 수 있습니다.
여기에 거리가 더해집니다. 최상위 모델은 생각을 길게 하는 편이라 같은 질문에도 토큰을 더 많이 씁니다. Anthropic은 생각 강도 '최대'를 토큰 사용에 제한을 두지 않는 단계라고 설명하고, Google은 Gemini 4 Argon이 생각하는 데 쓴 토큰까지 모두 요금에 넣는다고 밝힙니다. 그래서 실제 차이는 가격표보다 더 벌어집니다.
월 정액 요금제를 쓰면 돈 대신 사용 한도가 줄어듭니다. OpenAI는 GPT-6.1 Terra를 소개하면서 같은 한도로 GPT-6.1 Sol이나 GPT-6 Astra보다 "훨씬 더 많은 작업"을 처리할 수 있다고 설명합니다. 최상위 모델을 기본으로 켜 두면 오후가 되기 전에 하루 한도를 다 쓸 수도 있습니다.
비싼 모델을 쓰면 결과가 얼마나 좋아질까
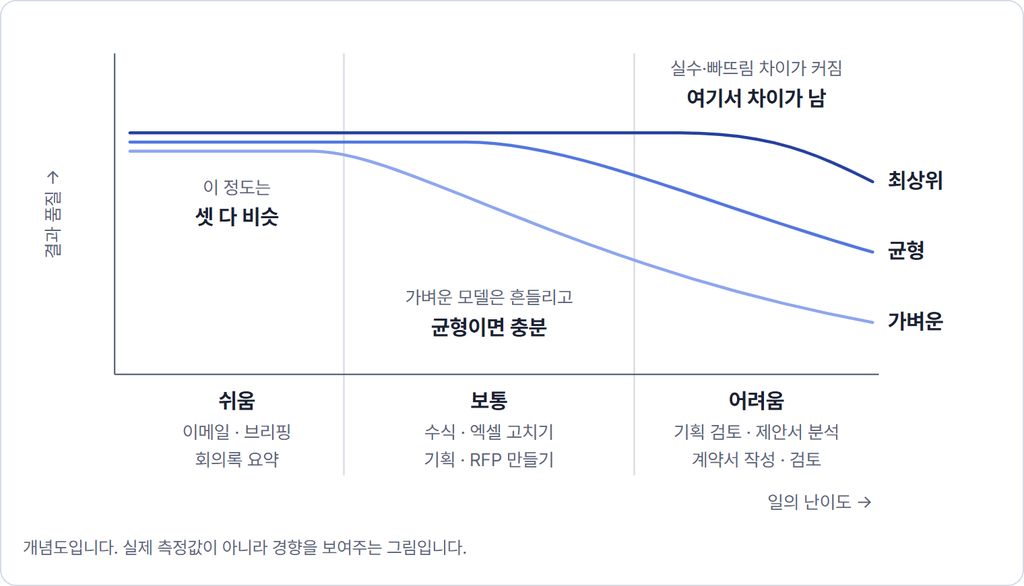
쉬운 일에서는 차이가 거의 안 보이고, 어려운 일에서만 보입니다.
외부 평가 점수로 비교해 보면
회사가 직접 발표한 숫자는 자기 모델에 유리한 시험 결과일 수 있습니다. 그래서 세 회사 모델을 같은 시험으로 채점하는 독립 평가 기관 Artificial Analysis의 수치를 가져왔습니다. 점수는 지식 업무·코딩·과학 등 9가지 시험을 묶은 종합 지수이고, 비용과 시간은 과제 1건을 끝내는 데 실제로 든 평균값입니다. 생각을 길게 할수록 토큰을 많이 써서 비용과 시간이 함께 늘어납니다.
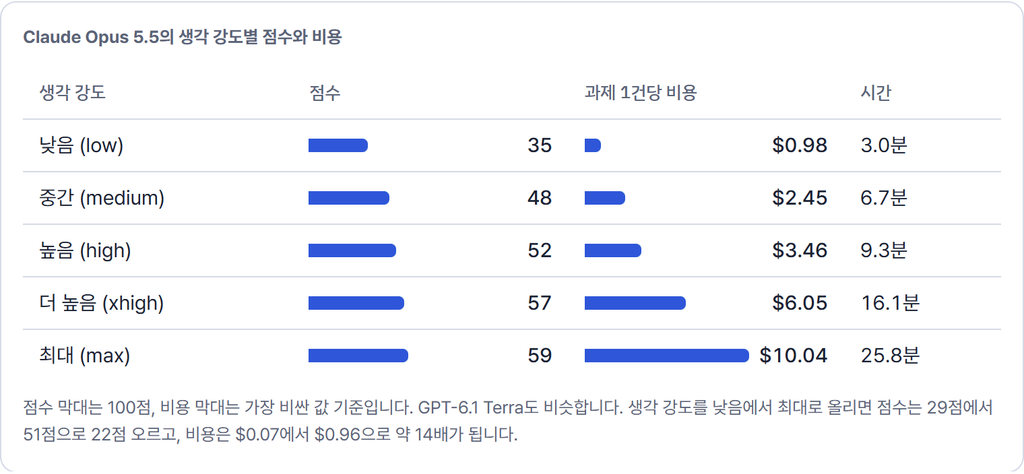
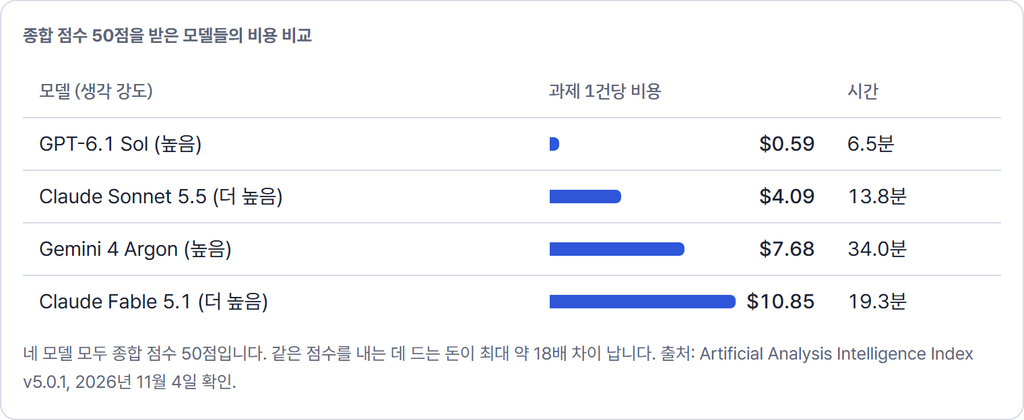
생각 강도를 올리면 점수보다 비용이 더 많이 오른다: Opus 5.5를 중간에서 최대로 올리면 점수는 48점에서 59점으로 11점 오르지만, 비용과 시간은 약 4배가 됩니다.
같은 돈이면 중간 모델에 생각을 더 시키는 게 낫다: 과제 1건 비용이 약 $4로 비슷할 때, Fable 5.1에 생각 강도 '낮음'으로 시키면 39점, Sonnet 5.5에 '더 높음'으로 시키면 50점이었습니다. GPT도 Astra '낮음'(43점, $1.42)보다 Terra '최대'(51점, $0.96)가 점수는 높고 비용은 낮았습니다.
가장 비싼 모델이 점수도 가장 높은 건 아니다: 이 종합 점수에서 Fable 5.1(최대)은 49점으로 Opus 5.5(최대) 59점보다 낮았고, 과제당 비용은 더 들었습니다($12.99 대 $10.04).
참고: 이 점수는 영어 위주 시험 9가지를 묶은 종합 지수라 모든 업무를 대표하지는 않습니다. Anthropic은 Fable 5.1을 오래 걸리는 복잡한 에이전트 작업용으로 안내합니다. 한국어 문서 품질이나 우리 회사 업무는 같은 일을 두세 개 AI에 직접 시켜 보고 판단하세요.
최상위 모델을 써서 달라지는 점은 평소에는 잘 보이지 않습니다. 어려운 일에서 빠뜨리는 항목과 실수가 줄어드는 정도입니다. 이메일 답장까지 최상위 모델에 맡길 필요는 없습니다.
언제 모델과 생각의 강도를 높일까
세 가지만 물어보면 됩니다.
틀리면 비싼가? 계약서, 대외 문서, 돈이 걸린 숫자라면 생각 강도를 올립니다.
한꺼번에 분석·비교할 자료가 많은가? 수백 쪽짜리 제안요청서나 여러 파일 비교라면 모델 등급을 올립니다.
결과를 내가 바로 확인할 수 있나? 이메일은 읽어보면 끝이라 낮게 둡니다. 복잡한 엑셀 모델이나 법률 문구처럼 확인이 어려운 일은 높게 둡니다.
AI별 성격
최신 모델끼리는 실력 차이가 크지 않습니다. 실제로 써 보면 내가 쓰는 메일·문서 도구와 잘 연결되는지가 더 중요합니다.
Claude | ChatGPT | Gemini | |
|---|---|---|---|
별명 | 꼼꼼한 문서통 | 만능 멀티툴 | 구글 업무 비서 |
강점 | 긴 문서 정리, 자연스러운 문장, 엑셀 수식·코드 작업 | 기능 선택의 폭이 넓음 (이미지 생성, 녹음 모드, 작업 예약, 심층 리서치) | Gmail·Google Drive 속 메일과 문서를 바로 요약 |
연결·확장 | 엑셀·문서 파일을 올리면 고친 파일로 돌려받기 | Excel, Word, PowerPoint, Google Sheets용 확장 프로그램, Microsoft 365·Slack 연결 (Business 기준) | 40개 넘는 앱 연결, 자주 쓰는 지시는 '스킬'로 저장 |
한 번에 읽는 양 | 약 100만 토큰 (API) | 약 320쪽 (Business 추론 모드) | 약 100만 토큰 (4 Argon, API) |
생각 강도 | 5단계 (low~max) | 즉답·추론 모드, 개발자용 low~max | 난이도에 맞춰 자동 조절, 개발자용 단계 선택 |
잘 맞는 일 | 계약서 초안·검토, 긴 제안서 분석, 기획서 다듬기 | 보고서·장표 만들기, 회의 녹음 정리, 매일 하는 일 예약 | 메일 회신, 데일리 브리핑, 구글 시트 작업 |
선택 기준: 회사 메일과 문서가 구글이면 Gemini, 마이크로소프트 365 중심이면 ChatGPT, 긴 문서와 글의 완성도가 중요하면 Claude부터 써보세요. 중요한 문서는 만든 AI와 다른 회사 AI에게 한 번 더 검토를 맡기면 놓친 부분이 잘 보입니다.
업무별 추천
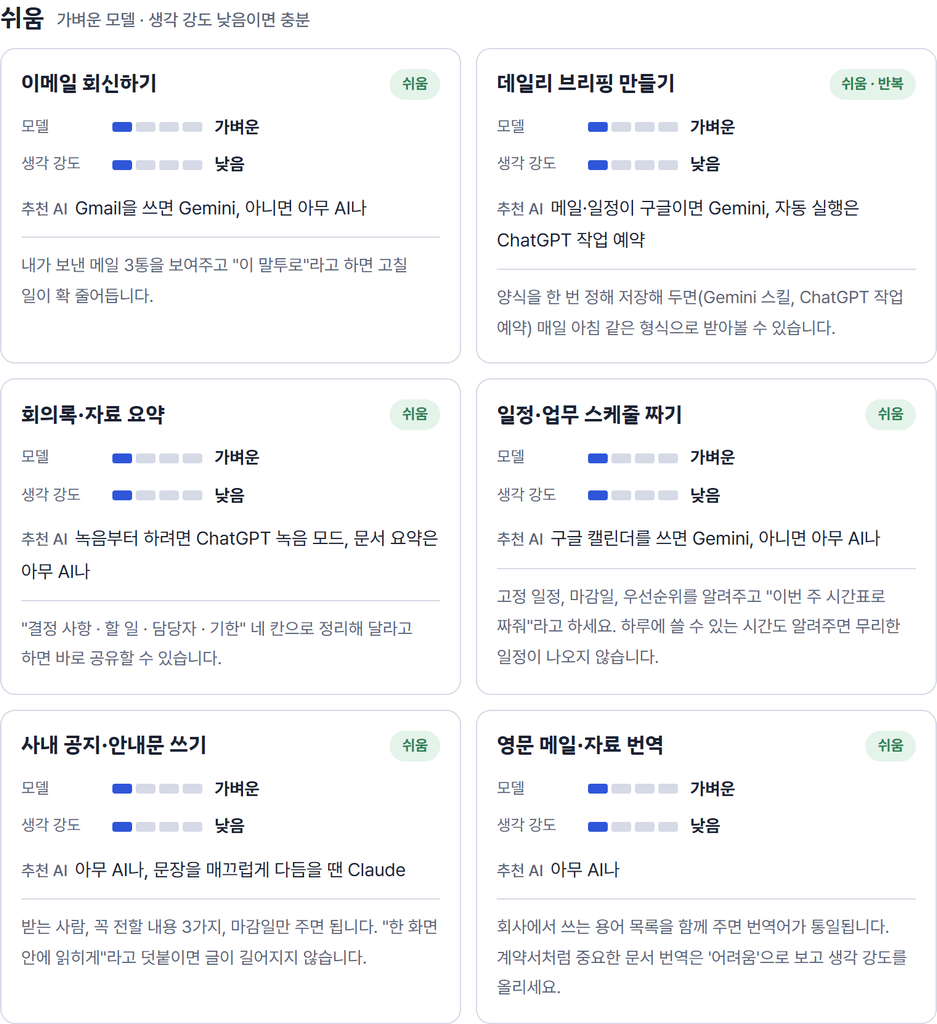
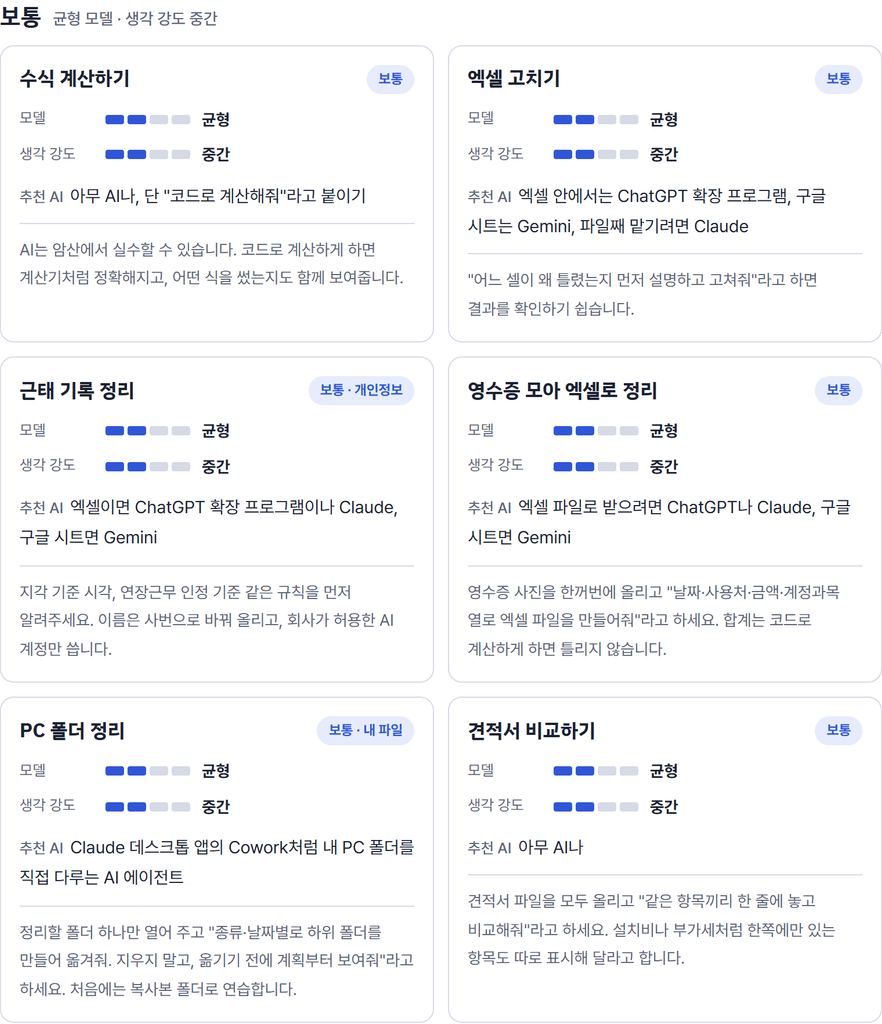
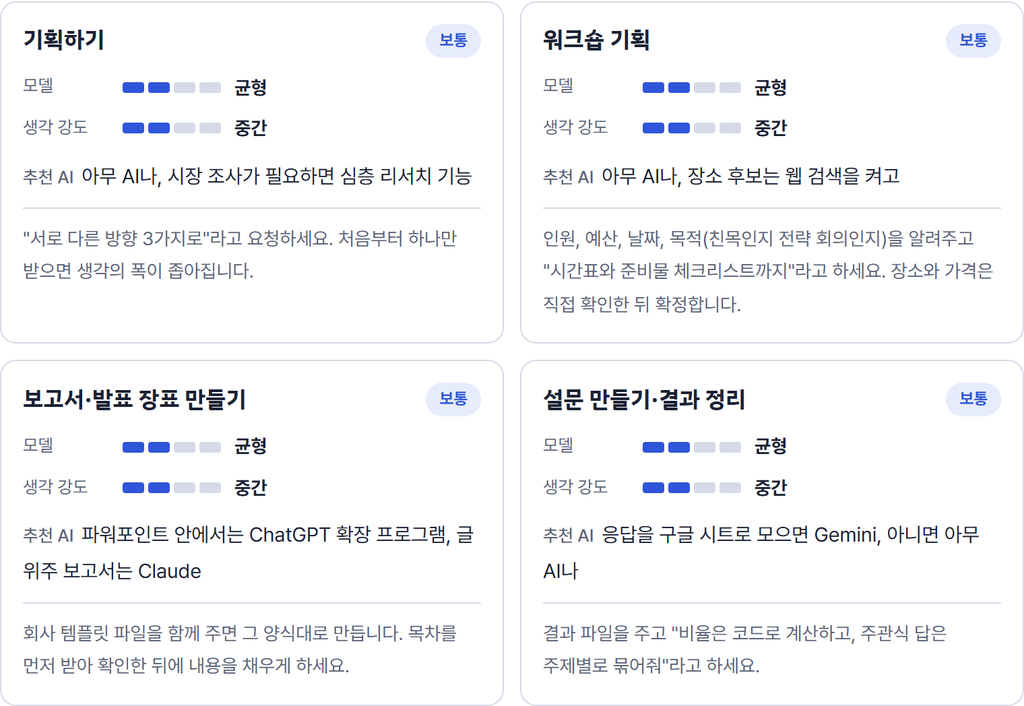
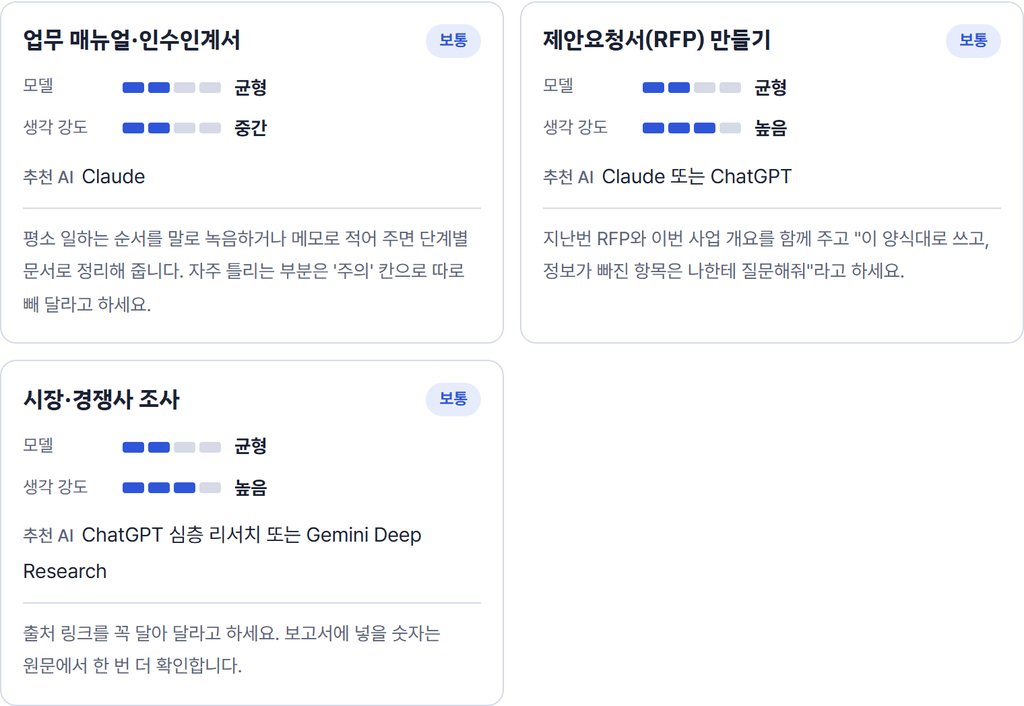
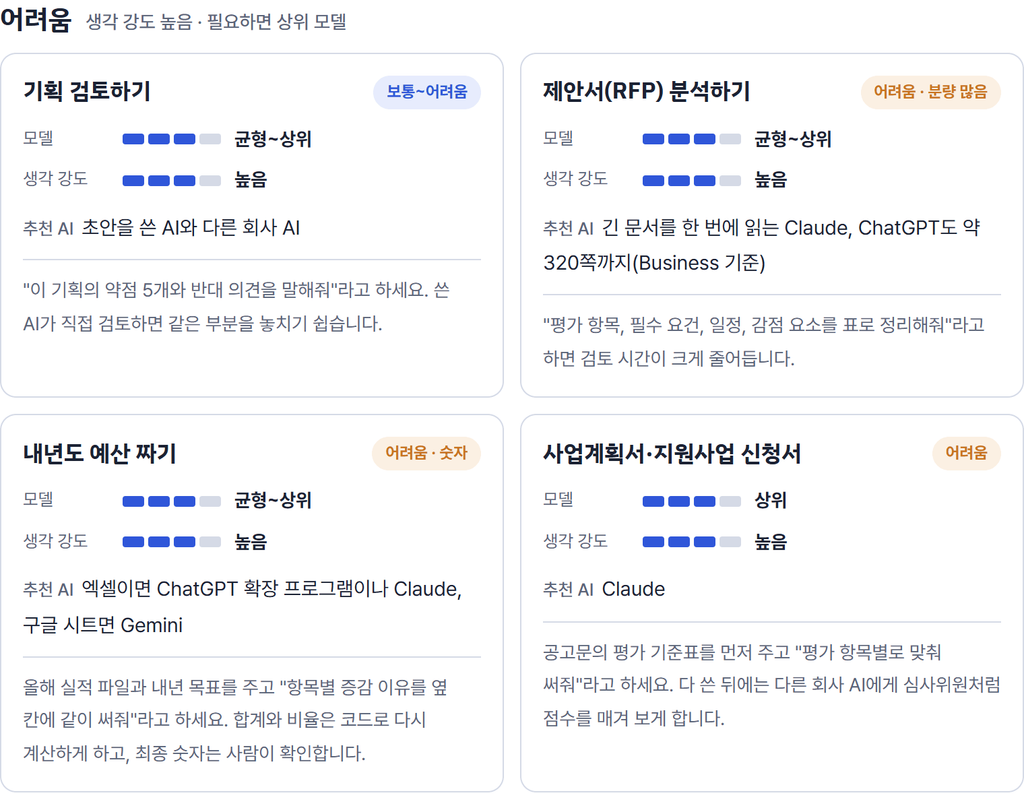
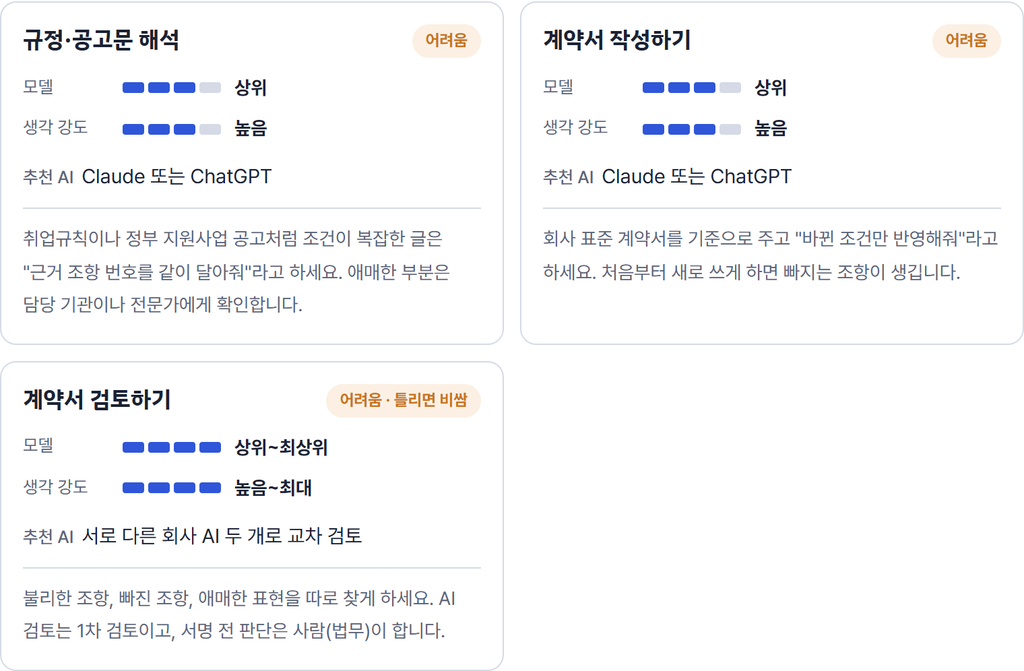
난이도별로 묶었습니다. 막대는 네 칸 중 몇 칸까지 올리면 되는지를 뜻합니다.
하루 업무에 적용해 보면
하루 일과로 따져 보면 최상위 모델이 꼭 필요한 일은 많지 않습니다.
시간 | 할 일 | 모델 · 생각 강도 |
|---|---|---|
09:00 | 데일리 브리핑 확인 | 가벼운 · 낮음 |
09:20 | 밀린 이메일 10통 회신 | 가벼운 · 낮음 |
10:00 | 120쪽 제안요청서 분석 | 균형 · 높음 |
13:30 | 정산 엑셀 수식 오류 수정 | 균형 · 중간 |
15:00 | 협력사 계약서 검토 | 상위 · 높음 (최종 판단은 법무) |
17:00 | 팀원 기획안 검토 | 다른 회사 AI · 높음 |
여섯 가지 일 중 상위 모델이 필요한 일은 한 번, 최상위 모델은 0번입니다. 아낀 한도는 정말 어려운 일이 생겼을 때 쓰면 됩니다.
마무리
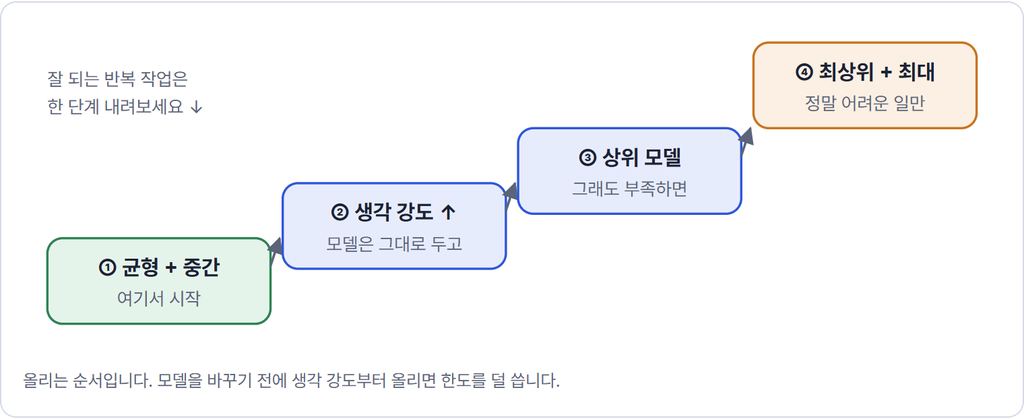
기본값은 균형 모델 + 중간으로 둡니다.
결과가 아쉬우면 생각 강도 → 모델 순서로 올립니다.
잘 되는 반복 작업은 한 단계 내려 봅니다. 아낀 한도는 어려운 일에 씁니다.
서비스별로 모델과 생각 강도 바꾸는 법
세 서비스 모두 입력창 근처의 모델 메뉴에서 바꿉니다.
Claude | ChatGPT | Gemini | |
|---|---|---|---|
바꾸는 곳 | 입력창의 보내기 버튼 옆 모델 메뉴 | 웹은 메시지 입력창 안, 모바일 앱은 대화 화면 위쪽의 모델 메뉴 | 입력창 아래쪽의 현재 모델 이름 |
모델 고르기 | 메뉴에서 모델 이름 선택 | 모드를 고르면 그에 맞는 모델이 자동으로 쓰임 | Flash-Lite, Flash, Pro, Argon 중 선택 |
생각 강도 | 같은 메뉴의 Effort에서 선택. 'Default' 표시가 그 모델의 권장값 | Instant, Medium, High 중 선택. Pro 요금제는 Extra High와 Pro 모드가 더 있음 | Low, Medium, High 중 선택. 고르지 않으면 Low로 시작 |
'균형 + 중간'에 가까운 설정 | Sonnet 5.5 + Medium | Medium | Flash + Medium |
알아둘 점 | 대화 중에 바꿔도 다음 답변부터 적용 | Instant가 필요할 때 Medium으로 넘어가게 할지는 설정 > 일반에서 켜고 끔 | 자물쇠 표시 모델은 상위 요금제 필요. Argon은 Google AI Pro·Ultra |
Claude와 Gemini는 2026년 11월 각 사 도움말, ChatGPT는 2026년 6월 OpenAI 공지 기준입니다. 메뉴 이름과 위치는 앱 업데이트에 따라 바뀔 수 있습니다.